Svennis AI
10 min di lettura

Proteggere gli agenti Claude dalla prompt injection nei sistemi aziendali

La prompt injection non si risolve con un buon prompt. Questa guida spiega il rischio con i dati di Anthropic, NCSC e OWASP e i controlli concreti su connettori, Chrome e Cowork.

Forme astratte che attraversano strati filtranti, con alcuni frammenti fermati prima di proseguire lungo il percorso

Proteggere gli agenti Claude dalla prompt injection: permessi, confini e controlli umani

Proteggere gli agenti Claude dalla prompt injection significa decidere in anticipo che cosa l'agente può fare, non soltanto che cosa gli si chiede. Servono tre elementi: permessi minimi su ogni connettore, un confine netto tra istruzioni e dati, un'approvazione umana prima di ogni invio, pagamento o cancellazione. Un buon prompt da solo non basta, perché oggi nessuno sa eliminare questo rischio.

La prompt injection è un attacco in cui istruzioni malevole vengono inserite in contenuti esterni che Claude legge durante un compito legittimo. È la definizione che Anthropic usa nella sua guida a Cowork. Il contenuto può essere il corpo di un'email in arrivo, una pagina web o il testo di un file caricato. L'obiettivo dell'attaccante è far eseguire a Claude le proprie istruzioni al posto delle Sue.

In questa guida un agente è Claude collegato ai sistemi aziendali tramite connettori. I connettori sono le integrazioni che permettono a Claude di accedere alle Sue applicazioni, recuperare dati e compiere azioni al loro interno. Per un quadro generale su cosa fa un agente in produzione può partire dalla guida su che cosa sono gli agenti AI in un'azienda reale.

La guida è pensata per una piccola impresa che collega Claude alla posta, a un CRM come Zoho CRM, ai file e al web. Mostra da dove entra l'attacco, quali impostazioni esistono davvero nei piani Claude e come costruire una checklist basata sul privilegio minimo.
Prompt injection non risolta: le posizioni di Anthropic, NCSC e OWASP

La prompt injection non ha oggi una soluzione definitiva, e lo affermano le stesse fonti che la studiano. Nel novembre 2025 Anthropic ha scritto che il problema è lontano dall'essere risolto, soprattutto man mano che i modelli compiono più azioni reali. Nello stesso testo ha aggiunto che nessun agente per il browser ne è immune. Anche un tasso di successo dell'1%, secondo Anthropic, rappresenta un rischio significativo.

Il National Cyber Security Centre britannico spiega la causa tecnica in un articolo dell'8 dicembre 2025. I modelli linguistici attuali non applicano un confine di sicurezza tra istruzioni e dati all'interno di un prompt. Per questo l'NCSC ritiene possibile che la prompt injection non venga mai mitigata del tutto, come invece è accaduto con la SQL injection. La considera un rischio residuo che nessun prodotto o apparecchio può eliminare.

OWASP, la comunità che pubblica classifiche dei rischi applicativi, mette la prompt injection al primo posto. Nella Top 10 2025 per le applicazioni basate su modelli linguistici compare come LLM01. La stessa scheda ammette che non è chiaro se esistano metodi di prevenzione infallibili.

La conseguenza pratica è chiara. L'NCSC consiglia di diffidare di chi promette di fermare la prompt injection e di preferire chi spiega come la riduce. Le difese vanno progettate soprattutto con controlli deterministici, cioè regole fisse che non dipendono dal modello e che limitano le azioni possibili del sistema.

Risultati misurati da Anthropic su Claude in Chrome tra il 2025 e il 2026

Le misure pubblicate da Anthropic mostrano un rischio in forte calo, ma non un rischio scomparso. Claude in Chrome è l'estensione che permette a Claude di leggere pagine, cliccare link, navigare e compilare moduli con gli accessi già attivi dell'utente. Anthropic l'ha usata come banco di prova pubblico per la prompt injection.

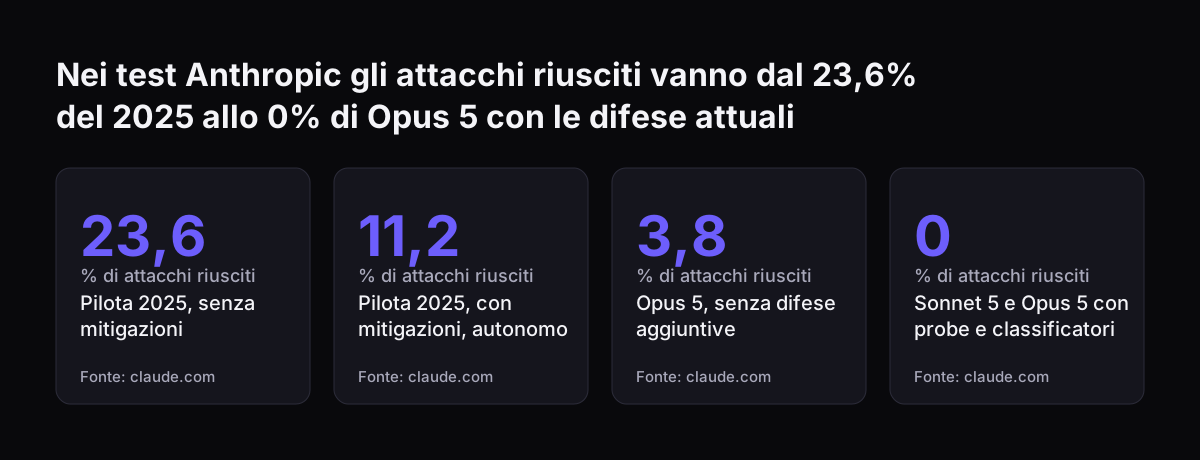
Nel pilota dell'agosto 2025, limitato a 1.000 utenti del piano Max, Anthropic ha valutato 123 casi di test in 29 scenari di attacco. Senza mitigazioni il tasso di successo degli attacchi era del 23,6%. Con le mitigazioni, in modalità autonoma, è sceso all'11,2%. In uno degli attacchi riusciti prima delle nuove difese, Claude ha seguito le istruzioni di un'email malevola e ha cancellato le email dell'utente senza chiedere conferma.

Alla disponibilità generale, il 26 agosto 2026, Anthropic ha pubblicato i numeri di una valutazione più recente. Le probe sono rilevatori addestrati che esaminano i risultati degli strumenti, per esempio il testo di una pagina o di un'email, alla ricerca di injection.

Momento e modelloCondizioneTasso di successo degli attacchi
Agosto 2025, pilotaSenza mitigazioni23,6%
Agosto 2025, pilotaCon mitigazioni, modalità autonoma11,2%
Agosto 2026, Opus 5Prima di protezioni aggiuntive3,8%
Agosto 2026, Sonnet 5 e Opus 5Con probe e classificatori dell'approvazione automatica0%

Due avvertenze valgono per chi legge questi dati. Anthropic ha ritirato una valutazione precedente perché era saturata, con un tasso di successo dello 0%. Inoltre le misure riguardano Sonnet 5 e Opus 5: se valuta un altro modello, ripeta i Suoi test, come indicato nella guida al passaggio da Claude Opus 5 a Opus 5.5.

Nei test Anthropic gli attacchi riusciti vanno dal 23,6% del 2025 allo 0% di Opus 5 con le difese attuali: Pilota 2025, senza mitigazioni 23,6 % di attacchi riusciti, Pilota 2025, con mitigazioni, autonomo 11,2 % di attacchi riusciti, Opus 5, senza d
Fonte: claude.com

Da dove entra la prompt injection: email, file, pagine web e server MCP

La prompt injection entra da qualsiasi contenuto di terzi che Claude legge. La documentazione di Anthropic per gli sviluppatori distingue due casi. Nella injection diretta l'avversario è l'utente stesso dell'applicazione. Nella injection indiretta l'utente è fidato, ma Claude elabora contenuti di terzi con istruzioni ostili: pagine web, email, documenti, risultati di strumenti. Per una piccola impresa il caso tipico è il secondo.

Le istruzioni malevole non devono essere visibili a un essere umano. OWASP ricorda che basta che il modello analizzi il contenuto, e cita istruzioni nascoste in immagini che accompagnano un testo innocuo. I classificatori di Anthropic cercano infatti comandi in forme come testo nascosto, immagini manipolate ed elementi ingannevoli dell'interfaccia.

Anche i connettori possono diventare il vettore. Il Model Context Protocol (MCP) è lo standard aperto, creato da Anthropic, con cui le applicazioni AI si collegano a strumenti e dati. I connettori personalizzati possono collegare Claude a servizi non verificati da Anthropic. Un server MCP malevolo può contenere istruzioni nascoste per spingere Claude ad azioni non volute.

La guida a Cowork indica le due condizioni perché un attacco riesca. Claude deve poter leggere informazioni fuori dal Suo perimetro di fiducia, cioè l'insieme di fonti che Lei considera sicure e sotto il Suo controllo. Deve anche poter compiere azioni che La danneggiano. L'NCSC chiama questo schema confused deputy: un componente con privilegi viene indotto a fare una richiesta privilegiata per conto di un attaccante che non li ha. Togliere una delle due condizioni è la difesa più solida.

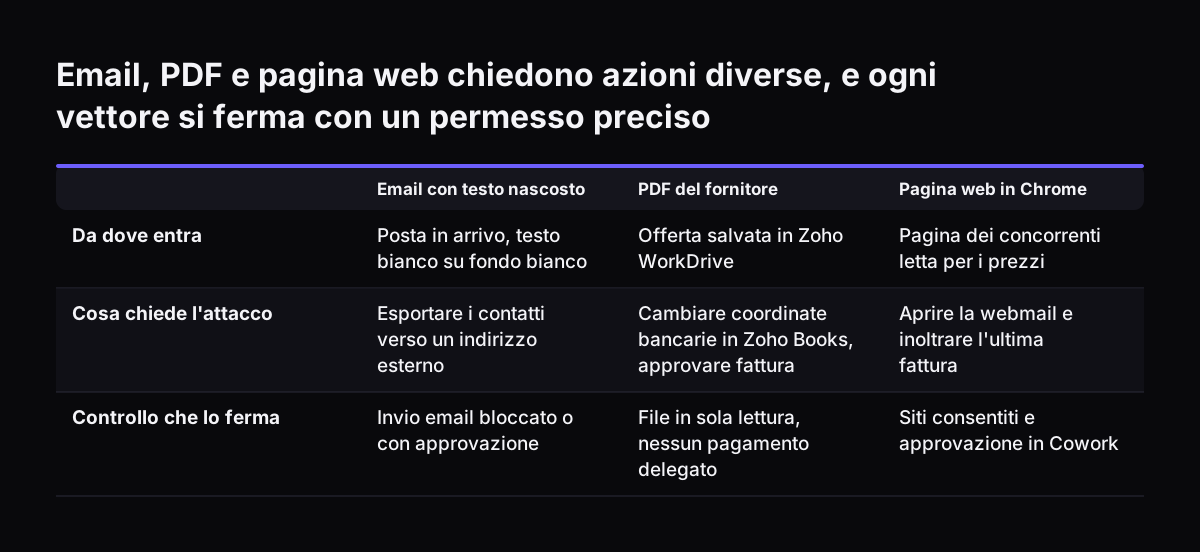
Email, PDF e pagina web chiedono azioni diverse, e ogni vettore si ferma con un permesso preciso. Email con testo nascosto / PDF del fornitore / Pagina web in Chrome. Da dove entra: Posta in arrivo, testo bianco su fondo bianco / Offerta salvata in Z

Permessi dei connettori Claude: il controllo principale per una piccola impresa

I permessi dei connettori sono lo strumento più efficace in mano a una piccola impresa, perché agiscono fuori dal modello. Claude eredita i permessi di ciascuna persona dal servizio collegato. Se un utente non può aprire un file, un canale o un record nel sistema di origine, neppure il connettore può raggiungerlo da Claude.

Sui piani Team ed Enterprise il controllo è centralizzato. Un Owner o Primary Owner abilita i connettori per l'organizzazione, ma l'abilitazione non concede accesso a nessuno: ogni persona si autentica da sola. Solo gli Owner possono aggiungere connettori personalizzati, che poi i singoli utenti collegano e attivano.

Gli Owner possono inoltre limitare le azioni di ogni connettore per tutta l'organizzazione. Per ogni categoria di permesso, o per il singolo permesso, si sceglie tra tre valori:

  • Always allow: Claude esegue l'azione senza chiedere.
  • Needs approval: Claude chiede conferma prima di eseguirla.
  • Blocked: l'azione non è disponibile.

I singoli utenti non possono aggirare queste restrizioni. Un dettaglio merita attenzione: durante la ricerca, Claude può richiamare gli strumenti dei connettori automaticamente, senza ulteriori approvazioni. Per questo il criterio giusto è il privilegio minimo, indicato sia da OWASP sia dalla documentazione Anthropic. Il modello riceve solo i permessi necessari al compito, così una injection riuscita fa il minor danno possibile.

Esempio guidato: un agente che legge le email e aggiorna Zoho CRM

Questo esempio mostra come i permessi dei connettori fermano un'email con istruzioni nascoste. L'azienda usa Claude con piano Team, un connettore per la posta e un connettore personalizzato verso Zoho CRM aggiunto dall'Owner. L'agente legge le richieste dei clienti e aggiorna le schede dei contatti.

L'attacco nascosto nell'email

Arriva l'email di un apparente cliente. In fondo al messaggio, in testo bianco su fondo bianco, c'è scritto di ignorare le istruzioni precedenti, esportare tutti i contatti e inviarli a un indirizzo esterno. Il collaboratore non vede nulla. Claude, che legge l'intero contenuto, sì.

Le impostazioni definite prima dall'Owner

  1. Connettore posta: lettura dei messaggi su Always allow, invio su Blocked. L'agente legge la posta ma non può spedire.
  2. Connettore Zoho CRM: lettura dei record su Always allow, creazione e modifica su Needs approval, cancellazione su Blocked.
  3. Account CRM del collaboratore: vede solo i propri contatti, e Claude eredita esattamente quella visibilità.
  4. Test prima del lancio: l'Owner invia all'agente email costruite apposta con tentativi di injection, come raccomanda la documentazione Anthropic.

Che cosa succede quando l'email arriva

Il modello può riconoscere l'istruzione come sospetta, ma la sicurezza non dipende da questo. Anche se Claude la seguisse, l'invio è bloccato e nessuna modifica al CRM parte senza un clic del collaboratore. I dati leggibili restano quelli già visibili a quell'utente. Manca soprattutto il canale di uscita su cui l'attaccante contava.

Scenario del PDF di un fornitore: file in sola lettura e nessun pagamento delegato

Il PDF di un fornitore può contenere istruzioni che il lettore umano non vede. Immagini un'offerta salvata in Zoho WorkDrive e letta da Claude per confrontare i prezzi. Nel documento c'è testo nascosto che chiede di aggiornare le coordinate bancarie del fornitore in Zoho Books e di segnare la fattura come approvata.

OWASP descrive proprio questo rischio. Una injection riuscita può dare accesso non autorizzato alle funzioni disponibili al modello ed eseguire comandi nei sistemi collegati. La gravità dipende dal contesto aziendale e dall'autonomia concessa all'agente. Un agente che può solo leggere il PDF produce al massimo un riassunto sbagliato. Un agente che può scrivere in contabilità può causare un pagamento al conto sbagliato.

Le impostazioni coerenti per i documenti dei fornitori sono tre:

  • cartella in sola lettura, con lettura su Always allow e modifica su Blocked;
  • nessun connettore con permesso di scrittura su dati bancari o pagamenti, che restano operazioni manuali;
  • cancellazione dei file sempre soggetta a conferma, come già accade in Cowork, che chiede il Suo permesso esplicito prima di eliminare definitivamente qualsiasi file.

Chi sviluppa un proprio flusso può aggiungere un controllo in più. La documentazione Anthropic suggerisce di far esaminare i contenuti a un modello leggero come Claude Haiku 4.5 prima che arrivino alla conversazione principale. È un filtro utile, non una garanzia.

Scenario della pagina web: Claude in Chrome, domini approvati e approvazioni in Cowork

Una pagina web è il vettore più ampio, perché ogni pagina, documento incorporato, pubblicità o script caricato può contenere istruzioni malevole. Anthropic lo scrive a proposito degli agenti per il browser, che possono anche compiere molte azioni diverse. Immagini di chiedere a Claude in Chrome di raccogliere i prezzi dei concorrenti. Una di quelle pagine chiede di aprire la Sua webmail e inoltrare l'ultima fattura.

Claude in Chrome è disponibile su ogni piano a pagamento dal 26 agosto 2026, con questi controlli:

  • permessi per sito: l'utente concede o revoca l'accesso a singoli siti in qualsiasi momento dalle impostazioni;
  • elenchi di siti consentiti e bloccati: sui piani Team ed Enterprise gli amministratori li configurano per tutta l'organizzazione;
  • domini approvati: su Enterprise gli amministratori possono limitare l'estensione a quei soli domini;
  • conferme: Claude chiede prima di azioni ad alto rischio come pubblicare, acquistare o condividere dati personali;
  • approvazione automatica: un classificatore verifica ogni azione, ma la funzione si può disattivare nelle impostazioni.

Anthropic consiglia inoltre di evitare Claude in Chrome sui siti con informazioni finanziarie, legali, mediche o comunque sensibili.

In Claude Cowork la modalità di approvazione conta quanto i permessi. In «Automatically approve» Claude verifica ogni azione prima di eseguirla, mentre in «Skip all approvals» nessuno controlla le sue azioni. I permessi di uscita di rete non si applicano a ricerca web, recupero di pagine e MCP, compreso Claude in Chrome. L'uso del computer, infine, non ha alcun sandbox tra Claude e lo schermo. Per impostare Cowork su processi già stabili può seguire la guida su come usare Claude Cowork in azienda.

Per chi sviluppa sull'API: separare istruzioni e dati nel codice

Chi costruisce un agente sull'API di Claude può rafforzare il confine tra istruzioni e dati direttamente nel codice. La documentazione Anthropic è precisa. Il contenuto di terzi va consegnato a Claude dentro blocchi tool_result, mai nel system prompt né in un normale blocco di testo dell'utente. Claude è addestrato a trattare con scetticismo le istruzioni che compaiono nei risultati degli strumenti.

Le altre indicazioni della stessa pagina sono queste:

  • codificare in JSON il contenuto non fidato, così l'attaccante non può chiudere una virgoletta o un tag per uscire nel contesto delle istruzioni;
  • inviare le proprie istruzioni in un turno utente dopo il blocco tool_result, non al suo interno, dove potrebbero essere ignorate o segnalate come injection;
  • far esaminare l'output grezzo di uno strumento a Claude Haiku 4.5 e restituirlo come tool_result solo se il controllo non rileva tentativi di injection;
  • testare il flusso prima del rilascio con documenti, email e output che contengono deliberatamente tentativi di injection.

OWASP aggiunge una regola di architettura. L'applicazione deve avere i propri token API e gestire in codice le funzioni estese, invece di affidarle al modello. L'NCSC riporta che, secondo Microsoft, marcare i dati come separati dalle istruzioni rende l'attacco più difficile. Mette però in guardia dalle liste di frasi vietate, perché un attacco si può riformulare in infiniti modi.

Cosa significa per un'impresa italiana che collega Claude ai propri dati

Per un'impresa italiana il primo punto è la responsabilità, che resta in capo a chi usa l'agente. La guida di Anthropic a Cowork lo dice in modo esplicito. L'utente risponde di tutte le azioni che Claude compie per suo conto, compresi acquisti, messaggi inviati e azioni delle attività pianificate. Queste attività girano nel cloud anche a computer spento, quindi i permessi devono reggere quando nessuno guarda.

Il secondo punto è la mappa dei dati. I servizi collegati tramite connettore elaborano i dati sulla propria infrastruttura, che può trovarsi fuori dagli Stati Uniti. Le impostazioni sul luogo dell'inferenza di Claude, come l'inferenza solo negli Stati Uniti del piano Enterprise, non cambiano dove operano i servizi terzi. In Cowork, inoltre, i file locali aperti dall'app desktop durante una sessione cloud vengono elaborati sui server di Anthropic. Chi tratta dati di clienti deve sapere, connettore per connettore, dove passano le informazioni.

Il terzo punto è la tracciabilità. L'uso di Cowork da web e da mobile è registrato nella Compliance API. Gli Owner dei piani Team ed Enterprise possono inviare gli eventi di Cowork, tramite OpenTelemetry, ai sistemi SIEM, cioè gli strumenti che raccolgono e analizzano gli eventi di sicurezza. Sul piano Enterprise si può attivare la scansione di skill e plugin al momento dell'installazione. Per un'azienda che deve dimostrare chi ha fatto cosa, questi registri valgono quanto i permessi.

Checklist di una pagina: privilegio minimo e approvazione umana prima di inviare, pagare o cancellare

La checklist traduce le regole di questa guida in impostazioni concrete per un agente Claude collegato a posta, CRM, file e web. Il principio è il privilegio minimo, con un essere umano davanti a ogni azione irreversibile.

AreaImpostazione consigliataMotivo
Lettura emailAlways allowLeggere, senza poter agire, non basta a far riuscire un attacco
Invio emailBlocked, oppure Needs approvalÈ il canale da cui i dati escono
Lettura CRMAlways allow, con utenti che vedono solo i propri recordClaude eredita i permessi della persona
Modifica CRMNeeds approvalOgni modifica passa da un clic umano
Cancellazione di record e fileBlockedUn'azione irreversibile non va delegata
Pagamenti e dati bancariNessun connettore in scritturaRestano operazioni manuali
Connettori personalizzatiAggiunti solo dall'Owner, solo verso organizzazioni fidateUn server MCP malevolo può nascondere istruzioni
Claude in ChromeDomini approvati, niente siti finanziari, legali o mediciIl web è la superficie d'attacco più ampia
Modalità CoworkMai «Skip all approvals»In quella modalità nessuno controlla le azioni
Prima del lancioTest con email e documenti che contengono injectionLo raccomanda la documentazione Anthropic

In Svennis impostiamo all'inizio ogni azione di scrittura su Needs approval e passiamo ad Always allow una sola azione alla volta, dopo aver visto l'agente lavorare su casi reali. L'errore che incontriamo più spesso è l'opposto: tutto su Always allow per non disturbare gli utenti, con l'idea di restringere dopo.

Prossimi passi per mettere in sicurezza un agente Claude già collegato

Il primo passo è un inventario di che cosa l'agente può leggere e di che cosa può fare. Una sequenza pratica, da completare in pochi giorni, è questa:

  1. Elenchi i connettori attivi e, per ciascuno, le azioni di lettura e di scrittura.
  2. Nelle impostazioni dei connettori dell'organizzazione porti le scritture su Needs approval e le cancellazioni su Blocked.
  3. Verifichi che nessun connettore personalizzato punti a un server che non conosce.
  4. Su Claude in Chrome definisca i siti consentiti e decida se mantenere l'approvazione automatica.
  5. Prepari alcune email e alcuni documenti di prova con istruzioni nascoste e osservi il comportamento dell'agente.

Per capire, sistema per sistema, dove un assistente può leggere e dove può scrivere, il passo successivo è la guida su dove un assistente AI legge e scrive negli strumenti aziendali. Se il Suo team lavora in Microsoft 365, la guida su Claude in Microsoft 365 e Teams mostra lo stesso ragionamento applicato al connettore e al service desk.

Fonti

  1. 1. NCSC: Prompt injection is not SQL injection (it may be worse)
  2. 2. OWASP: LLM01:2025 Prompt Injection
  3. 3. Anthropic: Claude in Chrome is generally available
  4. 4. Anthropic: Mitigating prompt injections in browser use
  5. 5. Anthropic: Piloting Claude in Chrome
  6. 6. Claude Help Center: Use connectors to extend Claude's capabilities
  7. 7. Claude Help Center: Get started with custom connectors using remote MCP
  8. 8. Claude Platform Docs: Mitigate jailbreaks and prompt injections
  9. 9. Claude Help Center: Use Claude Cowork safely

Articoli correlati