Svennis AI
9 min de citit

Seturi de test pentru răspunsurile Claude: primul tău set, înainte de lansare

Un set de test făcut din cereri reale îți arată dacă Claude răspunde corect înainte să ajungă la clienți. Ghidul arată cum îl construiești, cum notezi răspunsurile și când îl rulezi din nou.

Compoziție abstractă cu rânduri de forme identice, dintre care câteva se abat de la tipar și sunt marcate

Setul de test pentru răspunsurile Claude: ce este și de ce îl faci înainte de lansare

Un set de test pentru răspunsurile Claude este o listă de cereri reale ale clienților tăi. Fiecare cerere are lângă ea răspunsul așteptat sau regulile pe care răspunsul trebuie să le respecte. Îl construiești înainte de lansare. Apoi îl rulezi din nou după fiecare schimbare de prompt, de model sau de documente. Așa afli înaintea clienților că ceva s-a stricat.

Promptul înseamnă instrucțiunile pe care i le dai lui Claude: rolul, tonul, regulile și ce are voie să promită. O modificare mică în prompt poate repara un răspuns și poate strica alte trei. Fără un set de test, observi asta abia când un client se plânge.

Seturile de test pentru răspunsurile Claude nu sunt o idee de laborator. Documentația de modele a Anthropic pornește de la premisa că ai deja astfel de teste. Ea recomandă Claude Fable 5.1 pentru raționament dificil. Îl recomandă și atunci când „evals”, adică testele tale, pe Claude Opus 5.5 la efort mai mare tot nu ajung. Cu alte cuvinte, chiar furnizorul îți spune să alegi modelul după rezultatele pe cererile tale.

Multe firme se bazează în schimb pe impresie. Cineva încearcă cinci întrebări, răspunsurile sună bine și sistemul pleacă în producție. Un set de test înlocuiește impresia cu o listă pe care o poți număra: câte cereri au trecut, câte nu și care anume.
Cererile reale ale clienților sunt materia primă a setului de test

Setul de test pentru Claude se construiește din mesaje pe care clienții tăi le-au trimis deja, nu din întrebări inventate la birou. Întrebările inventate sunt prea curate. Clienții scriu scurt, amestecă subiecte, uită detalii și pun întrebarea reală abia în ultimul rând.

Sursele firești sunt tichetele din Zoho Desk, emailurile de la adresa de contact și conversațiile din chat. Dacă lucrezi cu Zoho CRM, notele de la apeluri și follow-up-urile spun și ele ce întreabă clienții. Merită să verifici întâi că aceste date sunt complete, cu pașii din ghidul despre date curate în Zoho CRM înainte de Claude.

Când alegi cererile, ai nevoie de trei categorii:

La Svennis construim setul de test din tichetele și emailurile reale ale clientului înainte să scriem varianta finală a promptului. Cele mai multe erori le vedem la mesajele care amestecă două subiecte, așa că punem intenționat astfel de cereri în fiecare set.

Înainte să copiezi o cerere în set, scoate numele, telefoanele, adresele și numerele de cont. Setul trebuie să păstreze forma problemei, nu identitatea clientului.

Răspunsul așteptat: ce scrii lângă fiecare cerere din setul de test

Lângă fiecare cerere din setul de test scrii criteriile pe care răspunsul lui Claude trebuie să le îndeplinească, nu un text de copiat cuvânt cu cuvânt. Claude nu va formula niciodată identic de două ori. Un test care cere textul exact pică mereu, chiar când răspunsul e bun.

Criteriile utile se împart de obicei în patru tipuri:

  • Ce trebuie să conțină: faptul corect, de exemplu termenul de livrare din politica ta sau pasul de resetare din manual.
  • Ce nu are voie să conțină: o promisiune de rambursare, un discount, o dată pe care nu o poți garanta.
  • Ce acțiune urmează: la ce echipă ajunge tichetul, când se predă unui om, ce câmp se completează.
  • Tonul: „dumneavoastră” cu clienții, fraze scurte, fără jargon intern.

Scrie criteriile cu omul care răspunde azi la aceste cereri. El știe ce înseamnă un răspuns bun și unde greșesc colegii noi. Managerul știe ce promisiuni nu are voie să facă firma.

Pentru întrebările cu răspuns din documente, notează și documentul sursă. Dacă răspunsul vine dintr-o politică de retur, scrie numele fișierului lângă criteriu. Când politica se schimbă, știi exact ce teste trebuie actualizate. Ghidul despre o bază de cunoștințe pentru Claude arată cum organizezi aceste documente.

Exemplu lucrat: un set de test pentru suportul din Zoho Desk

Exemplul de mai jos arată un set de test pentru un asistent de suport care primește tichete în Zoho Desk. Sistemul are două sarcini. Prima este rutarea: tichetul ajunge la echipa potrivită. A doua este un răspuns redactat, pe care colegul îl verifică înainte să-l trimită.

Pentru rutare, exemplul folosește Claude Haiku 5.5. Anthropic îl descrie pentru sarcini cu volum mare, sensibile la timpul de răspuns, cum ar fi clasificarea, extragerea și rutarea. Pentru răspunsul redactat folosește Claude Opus 5.5, modelul cu care Anthropic recomandă să începi când nu știi ce model să alegi.

Patru rânduri din set arată așa:

Cererea (anonimizată)Ce trebuie să conțină răspunsulUnde ajunge tichetul
„Am plătit factura de două ori luna asta, cum îmi recuperez banii?”Spune că plata se verifică. Nu promite rambursarea înainte de verificare. Folosește „dumneavoastră”.Facturare
„Comanda nu a ajuns, dar curierul zice că a livrat-o.”Cere numărul comenzii. Nu dă vina pe curier.Livrări
„Aplicația nu mai pornește după actualizare și am și o întrebare despre factură.”Tratează ambele subiecte, nu doar primul.Tehnic, cu notă pentru Facturare
„Vreau să vorbesc cu un om, nu cu un robot.”Confirmă politicos și predă conversația unui coleg.Escaladare la om

Rândul trei este cel care pică cel mai des la prima rulare. Al patrulea testează o regulă, nu o cunoștință. Același tipar de set funcționează și pentru triajul de email cu răspunsuri redactate de Claude, unde cererile vin pe email în loc de tichete.

Cum notezi răspunsurile lui Claude: trecut, de verificat, picat

Fiecare răspuns din setul de test primește o notă simplă, după criteriile scrise lângă cerere. Trei niveluri ajung pentru început: trecut, de verificat și picat. „De verificat” înseamnă că răspunsul nu încalcă nimic, dar un om l-ar scrie altfel.

Ideea unui verdict în trei trepte există și în dezvoltarea software cu Claude. În tutorialul DataCamp despre dezvoltarea bazată pe specificații, metoda BMAD încheie controlul de pregătire cu verdictul PASS, CONCERNS sau FAIL. Un FAIL te trimite înapoi la faza anterioară. La tine, un „picat” pe o regulă importantă te trimite înapoi la prompt.

Câteva reguli fac notarea utilă:

  • Notează aceeași persoană sau aceleași două persoane la fiecare rulare, ca notele să fie comparabile.
  • Păstrează rezultatele fiecărei rulări într-un tabel, cu data și versiunea promptului.
  • Marchează separat cererile la limită: un singur „picat” acolo poate cântări mai mult decât trei la cererile banale.

Pragul de lansare îl decizi tu, după risc. Un răspuns redactat pe care colegul îl citește înainte de trimitere suportă mai multe „de verificat”. Un răspuns trimis direct clientului nu suportă niciun „picat” pe promisiuni sau pe date.

Echipele tehnice pot rula setul automat. Claude Code poate fi integrat în GitHub Actions sau în alte sisteme CI/CD, în mod headless, cu comanda claude -p, conform tutorialului lui Vladimir Stajilov despre Claude Code. Notarea pe criterii de ton rămâne însă la un om.

Când rulezi din nou setul de test: prompt, model, documente și setări

Setul de test pentru Claude se rulează din nou la orice schimbare care poate modifica un răspuns. Nu doar la prompt. Tabelul de mai jos este lista de verificare pentru cele mai frecvente schimbări.

SchimbareaCe poate stricaCe rulezi
Modifici promptulTonul, regulile, formatul răspunsuluiTot setul
Treci la alt modelRutarea, lungimea răspunsurilor, respectarea regulilorTot setul, plus comparația de cost
Actualizezi documentele sau prețurileRăspunsuri cu cifre sau reguli vechiCererile pe subiectele atinse, apoi tot setul
Se schimbă setările organizațieiCererile care depind de unelte pot eșuaCererile care folosesc unelte
Adaugi un canal nouFormatul și predarea către omTot setul, în noul canal

Schimbarea de model vine sigur, mai devreme sau mai târziu. Anthropic publică pentru fiecare model o dată minimă de retragere. Pentru Claude Opus 5.5 este 22 septembrie 2027, pentru Claude Sonnet 5.5 este 28 septembrie 2027, iar pentru Claude Haiku 5.5 este 7 octombrie 2027. Cu un set de test, migrarea devine o rulare și o comparație, nu o lună de reclamații.

Setările organizației contează și ele. Documentația Anthropic notează că setările organizației pot face să eșueze o cerere care folosește o unealtă suportată. Exemplul dat este un administrator care dezactivează căutarea web. Rulează deci setul cu exact setările din producție. Același principiu e valabil când muți asistentul într-un canal intern, ca în ghidul despre Claude în Slack pentru suport intern.

Conversațiile cu mai multe ture și documentele lungi intră și ele în setul de test

Un set de test pentru Claude trebuie să conțină și conversații întregi, nu doar întrebări izolate. Clienții revin, precizează, se contrazic. Al treilea mesaj dintr-o conversație poate primi alt răspuns decât același mesaj trimis singur.

Motivul este felul în care lucrează Claude. Ghidul Whizi despre folosirea Claude explică faptul că modelul recitește toată conversația la fiecare tură. Un document atașat este reprocesat la fiecare tură a conversației în care se află. Un test cu mai multe ture verifică deci dacă Claude ține minte ce a spus clientul la început.

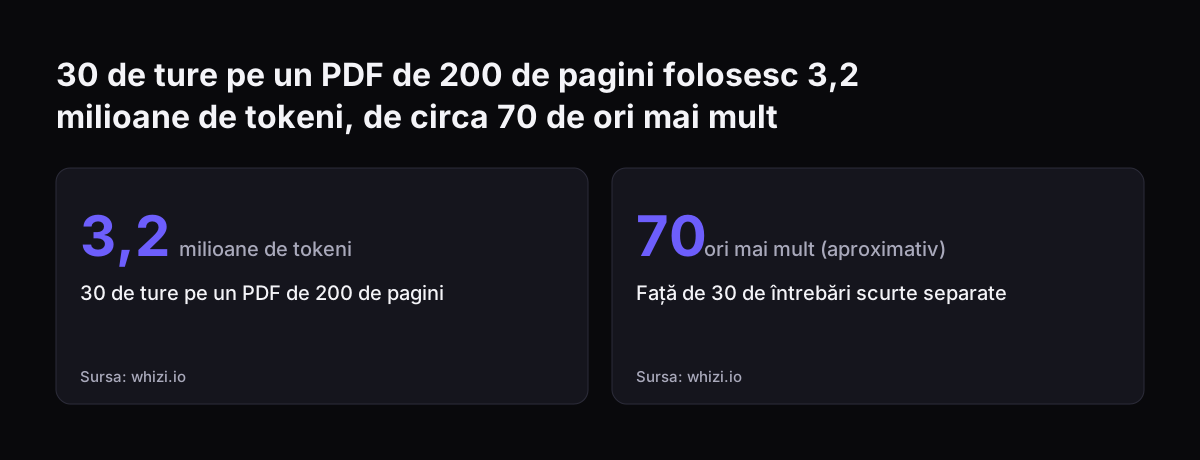
Documentele lungi au și un cost de rulare. Folosirea Claude se măsoară în tokeni, nu în mesaje. Același ghid estimează că 30 de ture pe un PDF de 200 de pagini folosesc 3,2 milioane de tokeni, de aproximativ 70 de ori mai mult decât 30 de întrebări scurte. Un set cu multe conversații pe documente mari costă la fiecare rulare.

Mai pune în set întrebări despre lucruri recente din firma ta. Cunoștințele proprii ale lui Claude se opresc la data de antrenament. Pentru modelele actuale, limita de cunoștințe fiabile este iunie 2026. O întrebare despre prețul de luna aceasta verifică dacă Claude răspunde din documentul tău, nu din ce crede că știe.

30 de ture pe un PDF de 200 de pagini folosesc 3,2 milioane de tokeni, de circa 70 de ori mai mult: 30 de ture pe un PDF de 200 de pagini 3,2 milioane de tokeni, Față de 30 de întrebări scurte separate 70 ori mai mult (aproximativ)
Sursa: whizi.io

Alegerea modelului Claude se face pe setul tău de test, nu pe anunțuri

Setul de test pentru răspunsurile Claude este și instrumentul cu care alegi modelul. Anunțurile Anthropic descriu performanța „pe majoritatea muncii”. Doar setul tău îți spune dacă munca ta face parte din majoritate.

Anthropic a anunțat că Claude Opus 5.5 lucrează la nivelul Claude Fable 5.1 pe majoritatea sarcinilor și costă cu 40% mai puțin decât Opus 5. Claude Sonnet 5.5 rulează cu 30% mai repede decât modelul Sonnet anterior și costă cu până la 30% mai puțin pentru majoritatea sarcinilor. Sunt cifre ale furnizorului, despre medii. Cererile tale pot fi excepția.

Prețurile din documentația de modele arată de ce merită testul. Claude Fable 5.1 costă 10 dolari pe milion de tokeni la intrare și 50 la ieșire. Claude Opus 5.5 costă 4 și 20, Claude Sonnet 5.5 costă 2 și 10. Claude Haiku 5.5 pornește de la 0,10 dolari la intrare și 0,50 la ieșire.

Metoda practică este simplă. Rulezi același set pe două modele și compari notele și costul. Dacă modelul mai ieftin trece aceleași cereri, inclusiv pe cele la limită, ai un argument măsurat. Dacă pică la rutare sau la reguli, ai și argumentul invers. Toate modelele actuale suportă text, imagini, mai multe limbi și unelte, deci diferența se vede în calitatea răspunsurilor, nu în funcții.

Seturi de test pentru o firmă din România: limbă, diacritice și date personale

O firmă din România are nevoie de un set de test scris în română, cu mesajele așa cum le trimit clienții ei. Documentația Anthropic spune că toate modelele actuale au capabilități multilingve. Asta nu îți spune cum se descurcă modelul cu stilul clienților tăi. Doar setul de test îți spune.

Câteva tipuri de cereri merită incluse intenționat:

  • mesaje scrise fără diacritice, cum le trimit mulți clienți de pe telefon;
  • mesaje care amestecă româna cu termeni în engleză, cum ar fi „lead”, „follow-up” sau numele produselor;
  • cereri formale, cu „dumneavoastră”, și cereri familiare, ca să vezi dacă tonul răspunsului rămâne cel stabilit de tine;
  • cereri cu cifre în lei, date și coduri de comandă, unde o confuzie costă bani.

Datele personale cer atenție separată. Setul de test circulă între colegi, ajunge în tabele și poate fi trimis unui partener tehnic. De aceea anonimizezi cererile înainte să intre în set, nu după.

Verifică și ce răspunde Claude când un client cere date despre altă persoană. Un răspuns corect refuză politicos și explică ce poate face firma. Pune cel puțin o astfel de cerere în fiecare set, pentru că testează o regulă, nu o cunoștință.

Primii pași pentru primul tău set de test, înainte de lansare

Primul set de test pentru răspunsurile Claude poate fi gata într-o săptămână de lucru, dacă îl construiești din cereri pe care le ai deja. Nu ai nevoie de un instrument special pentru început. Un tabel cu patru coloane ajunge: cererea, criteriile, nota și observațiile.

  1. Exportă tichetele și emailurile dintr-o perioadă obișnuită și anonimizează-le.
  2. Alege cererile frecvente, pe cele grele și pe cele la limită, cu omul care răspunde azi la ele.
  3. Scrie lângă fiecare cerere ce trebuie să conțină răspunsul, ce nu are voie să conțină și unde ajunge tichetul.
  4. Rulează setul cu promptul și modelul pe care vrei să le lansezi, cu setările din producție.
  5. Notează fiecare răspuns cu trecut, de verificat sau picat și repară promptul unde pică.
  6. Păstrează rezultatele și rulează din nou setul la fiecare schimbare din lista de verificare.

Dacă încă nu ai un asistent pe care să-l testezi, începe cu ghidul pentru primul agent AI cu Claude, fără cod. Construiește setul de test în paralel cu agentul. Astfel, prima versiune a promptului e deja verificată pe cererile reale ale clienților tăi.

Surse

  1. 1. Anthropic, Newsroom
  2. 2. Anthropic, Models overview
  3. 3. DataCamp, Dezvoltare bazată pe specificații cu Claude Code
  4. 4. Whizi, Cum să folosești Claude: ghid pentru începători
  5. 5. Vladimir Stajilov, Claude Code: tutorialul complet

Articole similare