Svennis AI
10 Min. Lesezeit

KI-Agenten im Betrieb: Freigaben, Protokolle, Kosten sicher steuern

Teil 3 der Reihe: Freigabestufen für schreibende Aktionen, Protokolle über OpenTelemetry und Audit-Logs, Ausgabenlimits pro Arbeitsbereich und eine Checkliste für den Start.

Abstrakte Linien, die nacheinander mehrere Kontrollpunkte passieren und an einer Schranke kurz innehalten

KI-Agenten im Betrieb: Freigaben, Protokolle und Kosten auf einen Blick

KI-Agenten im Betrieb: Freigaben, Protokolle, Kosten lassen sich mit drei Kontrollen beherrschen. Jede Aktion, die Daten verändert oder nach außen geht, braucht eine festgelegte Freigabe durch einen Menschen. Jeder Werkzeugaufruf landet in einem Protokoll. Jeder Arbeitsbereich erhält ein eigenes Ausgabenlimit mit Warnung.

Ein KI-Agent im Betrieb ist ein Agent, der nicht mehr im Test läuft. Er arbeitet mit echten Daten, echten Werkzeugen und echten Kunden. Was ein KI-Agent grundsätzlich ist, erklärt der Beitrag Was sind KI-Agenten? Aufbau, Grenzen und Kontrolle. Hier geht es um den Schritt danach, den laufenden Betrieb.

Dieser Leitfaden ist Teil 3 einer dreiteiligen Reihe. Teil 1 behandelt den ersten Agenten ohne Code, Teil 2 die Entwicklung mit dem Claude Agent SDK. Dieser Teil zeigt, welche Freigabestufen Anthropic anbietet und was die Protokolle festhalten. Er erklärt außerdem, wie Sie Kosten begrenzen und was die KI-Verordnung verlangt. Am Ende steht eine Checkliste mit sechs Punkten.
Freigaben: lesende Aktionen laufen frei, schreibende brauchen Regeln

Die Grundregel für Freigaben lautet: Ein Agent darf lesen, was er für seine Aufgabe braucht, aber verändern darf er nur nach klaren Regeln. Anthropic unterscheidet dafür im Hilfecenter zwei Arten von Werkzeugen. Lesewerkzeuge geben Claude Zugriff auf Inhalte, etwa auf ein E-Mail-Postfach oder auf Bildschirmfotos. Schreibwerkzeuge führen Aktionen aus, etwa eine Kalendereinladung erstellen, eine Datei löschen oder einen Befehl ausführen.

Schreibwerkzeuge tragen das höhere Risiko. Anthropic formuliert dazu in seinem Rahmenwerk für sichere und vertrauenswürdige Agenten einen klaren Grundsatz. Sinngemäß sollen Menschen die Kontrolle darüber behalten, wie ihre Ziele verfolgt werden, besonders vor folgenreichen Entscheidungen. Das Beispiel dort: Ein Nutzer kann das Lesen seines Kalenders immer erlauben, das Versenden einer Einladung aber an seine Zustimmung knüpfen.

Freigaben schützen auch vor Prompt Injection. Prompt Injection ist ein Angriff, bei dem Anweisungen in fremden Inhalten versteckt sind, die Claude während einer legitimen Aufgabe liest. Die Vertrauensgrenze umfasst die Quellen, die Sie als sicher und unter Ihrer Kontrolle betrachten, etwa eigene Dateien oder interne Kommunikation. Laut Anthropic gelingt der Angriff nur, wenn Claude Inhalte außerhalb dieser Grenze lesen und zugleich schädliche Aktionen ausführen kann.

Eine Freigabe vor jeder schreibenden Aktion unterbricht diese Kette. Die Verantwortung bleibt dabei beim Menschen. Nach Anthropic bleiben Nutzer für alle Aktionen verantwortlich, die Claude in ihrem Auftrag ausführt, auch für Käufe, gesendete Nachrichten und geplante Aufgaben.

Freigabestufen für Connector-Aktionen in den Tarifen Team und Enterprise

In den Tarifen Team und Enterprise legt der Inhaber des Kontos für jede Connector-Aktion eine von drei Stufen fest. Ein Connector ist die Verbindung, über die Claude auf ein anderes System zugreift. Die Stufen heißen „Always allow“ (immer erlauben), „Needs approval“ (Freigabe nötig) und „Blocked“ (gesperrt).

Die Einstellung gilt für die gesamte Organisation. Einzelne Nutzer können sie nicht überschreiben. Damit wird die Freigaberegel zu einer Unternehmensentscheidung. Sie hängt nicht mehr von der Vorsicht einzelner Mitarbeitender ab.

Claude Cowork bringt weitere Schalter mit. Cowork steht in allen bezahlten Tarifen auf dem Desktop bereit. Im Modus „Automatically approve“ prüft Claude jede Aktion vor der Ausführung auf Sicherheit. Im Modus „Skip all approvals“ prüft nichts die Aktionen. Für den produktiven Betrieb ist dieser zweite Modus deshalb ungeeignet.

Drei Eigenschaften von Cowork sollten Sie kennen, bevor Sie Freigaben festlegen:

  • Das dauerhafte Löschen von Dateien verlangt in jedem Modus Ihre ausdrückliche Erlaubnis.
  • Geplante Aufgaben laufen in der Cloud, auch wenn Ihr Computer ausgeschaltet ist.
  • Die Computersteuerung hat keine abgeschottete Umgebung (Sandbox) zwischen Claude und Ihrem Bildschirm und umgeht die Berechtigungsprüfungen der übrigen Werkzeuge.

Geplante Aufgaben handeln also, ohne dass jemand am Bildschirm sitzt. Gerade bei ihnen gehören schreibende Aktionen auf „Needs approval“.

Beispiel: Freigaben für einen Service-Agenten mit Zoho Desk und Zoho CRM

Ein typischer erster Agent im Betrieb liest Kundenanfragen und bereitet Antworten vor. Angenommen, Ihr Unternehmen nutzt Claude im Tarif Team. Der Agent liest Tickets in Zoho Desk und die zugehörigen Kundendaten in Zoho CRM. Er formuliert einen Antwortvorschlag, den ein Mitarbeiter prüft.

Welche Aktionen ein Connector genau anbietet, sehen Sie in den Connector-Einstellungen. Die folgende Tabelle zeigt, wie Sie die drei Stufen für diesen Agenten verteilen:

AktionWerkzeugartStufeGrund
Ticket und Verlauf lesenLesenAlways allowGrundlage jeder Antwort
Kundendatensatz lesenLesenAlways allowKontext für den Vorschlag
Interne Notiz am Ticket anlegenSchreibenNeeds approvalVerändert Daten, zu Beginn prüfen
Antwort an den Kunden sendenSchreibenNeeds approvalGeht nach außen
Datensatz im CRM ändernSchreibenNeeds approvalÄndert Stammdaten
Datensatz löschenSchreibenBlockedNicht umkehrbar

Die Logik dahinter ist einfach. Lesen bleibt frei, damit der Agent zügig arbeitet. Alles, was ein Kunde sieht oder was Daten verändert, wartet auf einen Menschen. Was sich nicht rückgängig machen lässt, bleibt gesperrt.

Nach einigen Wochen zeigen die Protokolle, welche Freigaben Mitarbeitende fast immer erteilen. Solche Aktionen können Sie später gezielt lockern. Wird eine Aktion dagegen oft abgelehnt, braucht der Agent bessere Anweisungen, nicht mehr Rechte.

Protokolle: was OpenTelemetry und Audit-Logs für die Nachvollziehbarkeit leisten

Nachvollziehbar bleibt ein Agent nur, wenn jeder Schritt protokolliert wird: die Anweisung, der Werkzeugaufruf, die Freigabe und die Kosten. Anthropic bietet dafür zwei Wege, die sich nach Tarif unterscheiden.

OpenTelemetry in Team und Enterprise

OpenTelemetry ist die Schnittstelle, über die Claude Ereignisse an Ihre eigenen Überwachungswerkzeuge streamt, etwa an ein SIEM. Ein SIEM ist ein System, das Sicherheitsereignisse sammelt und auswertet. Laut der Anleitung zur Überwachung mit OpenTelemetry streamt Claude Prompts, Werkzeugaufrufe, menschliche Freigabeentscheidungen, Tokens und geschätzte Kosten. Voraussetzung ist, dass ein Administrator einen Endpunkt einträgt.

Für Cowork über Mobilgerät und Web erfasst zusätzlich die Compliance API die Aktivität. Beide Quellen zusammen zeigen, wer welche Aktion ausgelöst und wer sie freigegeben hat.

Audit-Logs nur in Enterprise

Audit-Logs stehen nur im Tarif Enterprise zur Verfügung. Ein Export deckt 180 Tage ab. Wenn Sie Nachweise länger aufbewahren müssen, exportieren Sie regelmäßig und speichern die Dateien in Ihrem eigenen Archiv.

Richten Sie den OpenTelemetry-Endpunkt deshalb vor dem ersten produktiven Tag ein. Ohne diese Daten können Sie später weder eine falsche Antwort erklären noch die Kosten einem Prozess zuordnen.

Testsatz vor dem Start: 20 bis 50 Aufgaben aus echten Fehlern

Vor dem Start braucht jeder Agent einen Testsatz, also eine feste Sammlung von Aufgaben, an der Sie seine Leistung wiederholbar messen. Anthropic nennt solche Tests Evaluationen. Laut dem Engineering-Beitrag von Anthropic zu Evaluationen für Agenten sind 20 bis 50 einfache Aufgaben aus echten Fehlern ein sehr guter Anfang.

Echte Fehler finden Sie in abgelehnten Freigaben, in Beschwerden und in Tickets, die ein Mensch neu zuordnen musste. Jede dieser Situationen wird zu einer Testaufgabe mit einem erwarteten Ergebnis.

Wiederholung zählt mehr als ein einzelner Erfolg. Anthropic rechnet dazu ein Beispiel vor. Ein Agent im Kundenkontakt, der pro Versuch in 75 Prozent der Fälle erfolgreich ist, schafft drei Erfolge in Folge nur in etwa 42 Prozent der Fälle. Ein Kunde, der dreimal schreibt, erlebt also häufiger einen Fehler, als die erste Zahl vermuten lässt.

Führen Sie den Testsatz bei jeder Änderung erneut aus: bei neuen Anweisungen, neuen Werkzeugen und jedem Modellwechsel. Anthropic empfiehlt, im Zweifel mit Claude Opus 5.5 zu beginnen. Reichen die Ergebnisse auch mit höherer Effort-Einstellung nicht, empfiehlt Anthropic Claude Fable 5.1 für anspruchsvolles Denken und lange Agentenaufgaben.

Kosten planbar halten: Modellwahl, Ausgabenlimits und Arbeitsbereiche

Die Kosten eines Agenten hängen vor allem vom Modell und von der Menge der verarbeiteten Tokens ab. Tokens sind die Texteinheiten, nach denen Anthropic die Nutzung abrechnet. Die folgende Tabelle nennt die Preise laut Modellübersicht von Anthropic, in US-Dollar ohne Steuern, je Million Tokens:

ModellEingabeAusgabe
Claude Fable 5.110 USD50 USD
Claude Opus 5.54 USD20 USD
Claude Sonnet 52 USD10 USD
Claude Haiku 4.51 USD5 USD

Laut Anthropic arbeitet Claude Opus 5.5 bei den meisten Aufgaben auf dem Niveau von Claude Fable 5.1. Im Betrieb kostet es 40 Prozent weniger als Claude Opus 5. Für Claude Haiku 4.5 nennt Anthropic eine Abschaltung frühestens am 15. Oktober 2026. Planen Sie einen Wechsel rechtzeitig und prüfen Sie ihn mit Ihrem Testsatz.

Ausgabenlimits und Arbeitsbereiche in der Console

In der Claude Console legen Sie eine eigene monatliche Ausgabengrenze fest, die unter der Obergrenze Ihrer Nutzungsstufe liegt. Jeder Arbeitsbereich, in der Console Workspace genannt, erhält zusätzlich eigene Limits und Benachrichtigungen. Richten Sie deshalb pro Agent oder pro Prozess einen eigenen Arbeitsbereich ein.

So sehen Sie sofort, welcher Agent welche Kosten verursacht. Die geschätzten Kosten aus OpenTelemetry ergänzen das Bild auf der Ebene der einzelnen Aufgabe.

Was die KI-Verordnung für Unternehmen in Deutschland bedeutet

Für Unternehmen in Deutschland gilt die europäische KI-Verordnung, auch AI Act genannt, und zwei Artikel betreffen Agenten im Betrieb besonders. Den Volltext mit Erläuterungen finden Sie auf der Seite EU AI Act (KI-Verordnung) mit Erläuterungen.

Artikel 4: KI-Kompetenz der Mitarbeitenden

Artikel 4 verlangt von Anbietern und Betreibern, die KI-Kompetenz ihres Personals zu fördern. Ein Betreiber ist ein Unternehmen, das ein KI-System in eigener Verantwortung einsetzt. Laut den Fragen und Antworten der EU-Kommission zur KI-Kompetenz ist dafür kein Zertifikat nötig. Wer Freigaben erteilt, sollte trotzdem wissen, was der Agent tut und wo er irrt.

Artikel 50 Absatz 1: Transparenz im Kundenkontakt

Artikel 50 Absatz 1 gilt ab dem 2. August 2026 und betrifft KI-Systeme, die mit Menschen interagieren. Die Pflicht trifft den Anbieter des Systems. Menschen sollen erkennen können, dass sie mit einer KI sprechen.

Ein Unternehmen, das seinen eigenen Agenten für den Kundenkontakt baut, kann selbst Anbieter dieses Systems sein. Ob das bei Ihnen zutrifft, klären Sie mit einer Anwältin oder einem Anwalt. Protokolle und dokumentierte Freigaben helfen in jedem Fall, den Einsatz nachvollziehbar zu belegen.

Checkliste für den produktiven Betrieb: sechs Punkte vor dem Start

Vor dem Start eines Agenten sollten sechs Punkte schriftlich geklärt sein. Die Tabelle nennt für jeden Punkt, was Sie festlegen und womit Sie es umsetzen:

PunktWas Sie festlegenUmsetzung
Verantwortliche PersonWer den Agenten fachlich verantwortet und Änderungen freigibtName im Prozessdokument
FreigabenStufe für jede Connector-AktionAlways allow, Needs approval, Blocked in Team und Enterprise
ProtokolleWohin Ereignisse fließen und wie lange sie aufbewahrt werdenOpenTelemetry-Endpunkt, Audit-Log-Export in Enterprise
AusgabenlimitMonatliche Grenze und WarnschwellenLimits pro Arbeitsbereich in der Console
Testsatz20 bis 50 Aufgaben aus echten FehlernWiederholung bei jeder Änderung
Monatliche PrüfungAbgelehnte Freigaben, Fehler, KostenFester Termin mit der verantwortlichen Person

Die monatliche Prüfung hält die übrigen Punkte aktuell. Bei Svennis beginnen wir diese Prüfung mit den abgelehnten Freigaben, weil sie am schnellsten zeigen, wo Anweisungen oder Rechte des Agenten nicht passen. Erst danach stellen wir einzelne Aktionen von „Needs approval“ auf „Always allow“ um, und nur mit Zustimmung der verantwortlichen Person.

Halten Sie jede Änderung an Freigaben, Modell oder Limit im Protokoll der Prüfung fest. So bleibt auch später nachvollziehbar, warum der Agent heute so arbeitet.

Nächste Schritte: den eigenen Agenten in den geprüften Betrieb bringen

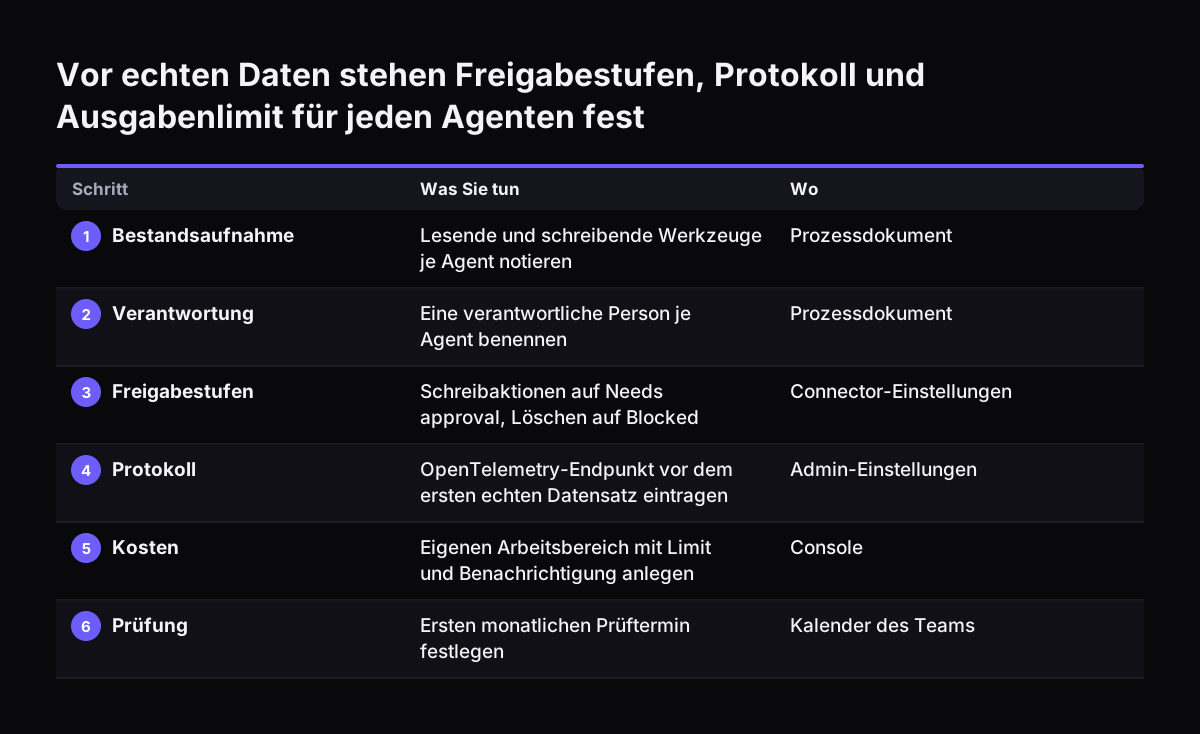
Der erste Schritt ist eine Bestandsaufnahme. Schreiben Sie für jeden laufenden oder geplanten Agenten auf, welche Werkzeuge er lesen und welche er schreiben darf. Daraus ergibt sich die Freigabestufe jeder Aktion fast von selbst.

Danach gehen Sie in dieser Reihenfolge vor:

  1. Legen Sie eine verantwortliche Person je Agent fest.
  2. Setzen Sie alle schreibenden Connector-Aktionen zunächst auf „Needs approval“ und Löschaktionen auf „Blocked“.
  3. Tragen Sie den OpenTelemetry-Endpunkt ein, bevor der Agent mit echten Daten arbeitet.
  4. Richten Sie einen eigenen Arbeitsbereich mit Limit und Benachrichtigung ein.
  5. Sammeln Sie 20 bis 50 Testaufgaben aus echten Fehlern.
  6. Planen Sie den ersten monatlichen Prüftermin.

Wenn Sie zuerst wissen möchten, wo Ihr Unternehmen steht, hilft der KI-Readiness-Check für Ihr Unternehmen. Soll ein Agent fest in Ihre Abläufe eingebunden werden, finden Sie die Einzelheiten auf der Seite KI-Automatisierung für den Mittelstand.

Vor echten Daten stehen Freigabestufen, Protokoll und Ausgabenlimit für jeden Agenten fest. Was Sie tun / Wo. 1. Bestandsaufnahme: Lesende und schreibende Werkzeuge je Agent notieren / Prozessdokument; 2. Verantwortung: Eine verantwortliche Person je

Quellen

  1. 1. Anthropic: Our framework for developing safe and trustworthy agents
  2. 2. Claude Help Center: Use Claude Cowork safely
  3. 3. Claude Help Center: Monitor Claude Cowork activity with OpenTelemetry
  4. 4. Claude Help Center: Access audit logs
  5. 5. Claude Platform Docs: Workspaces
  6. 6. Anthropic Engineering: Demystifying evals for AI agents
  7. 7. Claude Platform Docs: Models overview
  8. 8. Anthropic Newsroom
  9. 9. EU-Kommission: AI Literacy, Questions and Answers
  10. 10. EU-Kommission: Transparency obligations under Article 50 AI Act

Verwandte Beiträge