Svennis AI
10 min di lettura

Misurare un assistente AI nell'help desk: assegnazione corretta, tempi ed escalation

Tre metriche bastano per sapere se un assistente AI nel service desk funziona. Questa guida spiega come definirle, cosa registrare e come impostarle prima del go-live.

Composizione astratta di flussi che si dividono in percorsi distinti e convergono verso punti di misura

Misurare un assistente AI: tre metriche da fissare prima del lancio

Per misurare un assistente AI nel customer service o nell'help desk bastano tre metriche, fissate prima del lancio. Sono la prima assegnazione corretta, il tempo di gestione risparmiato e il tasso di escalation verso un operatore. Ognuna richiede un valore di partenza, rilevato sul processo attuale, e un campo registrato in ogni conversazione.

Misurare un assistente AI significa confrontare ciò che l'assistente fa con un criterio scritto in anticipo. Le richieste usate per il confronto sono quelle che arrivano davvero al Suo team. Il confronto vale solo se il criterio esiste prima del go-live. Dopo il lancio manca il termine di paragone, perché il processo precedente non c'è più.

La documentazione di Anthropic parte dallo stesso principio. Secondo la guida ai criteri di successo e alle valutazioni, un'applicazione basata su un modello linguistico parte da criteri di successo definiti con chiarezza. Solo dopo si progettano le prove che misurano le prestazioni rispetto a quei criteri. La stessa guida osserva che la maggior parte dei casi d'uso richiede una valutazione su più criteri insieme.

Per un help desk su Zoho Desk o su un altro sistema di ticketing, i tre criteri coprono le domande reali di un responsabile. La richiesta arriva alla persona giusta? Il team lavora meno per ogni ticket? I casi difficili passano a un essere umano quando serve? Le sezioni seguenti trattano ciascuna metrica, i dati da registrare e un esempio completo.
Prima assegnazione corretta: la metrica che dice se lo smistamento funziona

La prima assegnazione corretta è la quota di richieste che l'assistente AI invia subito al reparto o alla persona giusti, senza che nessuno debba riassegnarle. È la metrica più diretta per un assistente che smista ticket, perché un errore di smistamento si vede subito come lavoro in più.

Per calcolarla servono due informazioni per ogni ticket. La prima è il reparto proposto dall'assistente al momento dell'apertura. La seconda è il reparto in cui il ticket viene effettivamente chiuso. Se coincidono, l'assegnazione era corretta. Se il ticket è stato spostato, l'assegnazione era sbagliata, e il motivo dello spostamento indica dove intervenire.

Il confronto tra le due informazioni è un caso di exact match evaluation. La documentazione di Anthropic la definisce come la verifica che l'output del modello coincida con una risposta corretta predefinita, di solito dopo aver normalizzato spazi e maiuscole. Per lo smistamento la risposta corretta è il reparto finale, quindi il controllo si fa con poche righe di logica, senza giudizi soggettivi.

Il valore di partenza va rilevato prima del lancio. Basta guardare quanti ticket, nelle settimane precedenti, sono stati riassegnati dopo il primo smistamento manuale. Quel numero è il termine di paragone onesto: l'assistente non deve essere perfetto, deve fare meglio del processo che sostituisce.

Tempo di gestione risparmiato: come misurarlo con un valore di partenza

Il tempo di gestione è il tempo che un operatore dedica a un ticket, dalla presa in carico alla chiusura. Il tempo risparmiato è la differenza tra il tempo medio prima dell'assistente e il tempo medio dopo, sullo stesso tipo di richieste.

La condizione «sullo stesso tipo di richieste» è decisiva. Se l'assistente risolve da solo le domande semplici, ai colleghi restano solo i casi complessi. Il loro tempo medio per ticket può quindi salire anche se il carico complessivo scende. Confrontare medie generali porta a conclusioni sbagliate in entrambe le direzioni.

Per evitare l'errore conviene misurare il tempo di gestione per categoria di richiesta. Le categorie sono quelle che il Suo help desk usa già: accessi e password, hardware, fatturazione, resi, e così via. Per ogni categoria si registrano tre valori:

  • il tempo medio di gestione prima del lancio, calcolato su un periodo di attività normale;
  • il tempo medio dopo il lancio, per i ticket che passano comunque da un operatore;
  • la quota di richieste della categoria chiuse dall'assistente senza intervento umano.

La documentazione di Anthropic avverte che le metriche di successo non devono essere irrealistiche rispetto alle capacità attuali dei modelli. Per il tempo di gestione questo significa fissare un obiettivo per categoria, non una promessa unica per tutto il servizio. Su alcune categorie il risparmio sarà netto, su altre quasi nullo, ed è un'informazione utile in entrambi i casi.

Escalation verso un operatore: quando è un buon segno e quando no

Un'escalation è il passaggio di una richiesta dall'assistente AI a un operatore umano. Il tasso di escalation è la quota di conversazioni che finiscono così. Da solo questo numero non dice se l'assistente funziona, perché un'escalation può essere corretta o sbagliata.

Un'escalation corretta è quella prevista dalle regole. Una richiesta che tocca dati sensibili, un reclamo o un problema che l'assistente non ha gli strumenti per risolvere devono arrivare a una persona. In questi casi un tasso basso sarebbe un segnale di rischio, non un successo.

Un'escalation sbagliata ha due forme. La prima è l'escalation inutile: l'assistente passa a un operatore una domanda a cui poteva rispondere. La seconda è l'escalation mancata: l'assistente insiste su una richiesta che doveva cedere. La seconda forma è la più costosa, perché il cliente o il collega resta senza risposta.

Per distinguere i tre casi, ogni escalation va registrata con il motivo dichiarato dall'assistente. Un campione delle conversazioni chiuse senza escalation va poi controllato per trovare quelle mancate. Segnali utili sono le risposte del tipo «non ho questa informazione» e i messaggi in cui l'utente scrive di non essere stato capito. Una conversazione che termina così non è un successo, anche se nessun operatore è intervenuto.

Cosa registrare in ogni conversazione per poter misurare l'assistente

Le tre metriche dipendono da pochi campi registrati in ogni conversazione, scritti dal sistema e non ricostruiti a mano dopo. Se un campo manca al lancio, la metrica corrispondente non si potrà calcolare per tutto il periodo in cui è mancato.

I campi minimi da registrare per ogni richiesta gestita dall'assistente sono questi:

  • la data e l'ora di arrivo della richiesta;
  • la categoria assegnata dall'assistente;
  • il reparto o l'assegnatario proposto dall'assistente;
  • il reparto o l'assegnatario finale alla chiusura del ticket;
  • l'esito: risolta dall'assistente oppure passata a un operatore;
  • il motivo dell'escalation, quando c'è;
  • il tempo di gestione dell'operatore, quando interviene.

Il punto in cui registrare questi campi dipende da dove l'assistente legge e scrive. Se l'assistente apre ticket nel sistema di help desk, i campi vanno nel ticket stesso, accanto a quelli che il team usa già. Il post su dove un assistente AI legge e scrive negli strumenti aziendali spiega come scegliere questi punti di contatto.

Il testo completo delle conversazioni è un tema a parte. Serve per controllare un campione e per capire gli errori, ma contiene quasi sempre dati personali. La sezione sull'Italia, più avanti, spiega perché registrare solo ciò che serve.

Criteri di successo scritti prima del go-live: specifici, misurabili, raggiungibili, pertinenti

Un criterio di successo è una frase che dice quale risultato l'assistente deve raggiungere, su quali dati e con quale soglia. La documentazione di Anthropic indica quattro qualità: il criterio deve essere specifico, misurabile, raggiungibile e pertinente.

La stessa documentazione propone esempi di formulazione che si possono imitare. Un criterio di velocità è scritto come «il 95% dei tempi di risposta sotto i 200 millisecondi». Un criterio di sicurezza è scritto come «meno dello 0,1% degli output, su 10.000 prove, segnalato per tossicità dal filtro dei contenuti». Un criterio sulla gravità degli errori dice che il 90% degli errori deve causare solo un disagio, non un errore grave. Questi numeri sono esempi di forma, non obiettivi da copiare per il Suo help desk.

Applicati alle tre metriche, i criteri assumono una forma simile. La prima assegnazione corretta deve superare il valore di partenza del processo manuale, misurato su un campione di ticket reali. Il tempo di gestione deve scendere in categorie nominate. Le escalation previste dalle regole devono avvenire tutte, e quelle inutili restare sotto una soglia concordata.

La documentazione aggiunge che anche temi apparentemente vaghi, come l'etica e la sicurezza, si possono quantificare. Per un help desk vale lo stesso per il tono delle risposte. La guida descrive una scala Likert valutata da un modello linguistico: un giudizio da 1 a 5 sul tono, assegnato in modo ripetibile.

Esempio pratico: un assistente che smista le richieste IT verso Zoho Desk

Questo esempio segue un assistente AI che riceve richieste IT dai colleghi in Microsoft Teams, sceglie categoria e reparto e apre il ticket nell'help desk. Un'architettura di questo tipo si adatta alle aziende che usano già Microsoft Teams e Zoho Desk.

La preparazione segue quattro passaggi, tutti prima del go-live:

  1. Estrarre dall'help desk un campione di ticket già chiusi, con il reparto finale di ciascuno.
  2. Controllare che il campione rispecchi la distribuzione reale delle richieste e includa i casi limite, come raccomanda la documentazione di Anthropic.
  3. Far smistare il campione all'assistente e confrontare il reparto proposto con quello finale tramite exact match.
  4. Scrivere la soglia di accettazione e decidere chi la verifica dopo il lancio.

Nei progetti di Svennis aggiungiamo al ticket il campo del reparto proposto dall'assistente prima ancora di scrivere le istruzioni del modello: senza quel campo, dopo il lancio la prima assegnazione corretta non si può più ricostruire. La tabella riassume l'impostazione delle metriche nell'esempio.

MetricaCome si calcolaCampo da registrareValore di partenza
Prima assegnazione correttaReparto proposto uguale al reparto finaleReparto proposto e reparto finaleTicket riassegnati nel processo manuale
Tempo di gestioneMedia per categoria, prima e dopoCategoria e tempo dell'operatoreMedia per categoria prima del lancio
EscalationQuota passata a un operatore, per motivoEsito e motivo dell'escalationCasi che le regole riservano a una persona
Richieste senza risposta utileCampione letto o valutato da un modelloTesto della conversazione, solo per il campioneNessuno: si misura dal lancio

Valutare le risposte: controllo via codice, revisione umana o un secondo modello

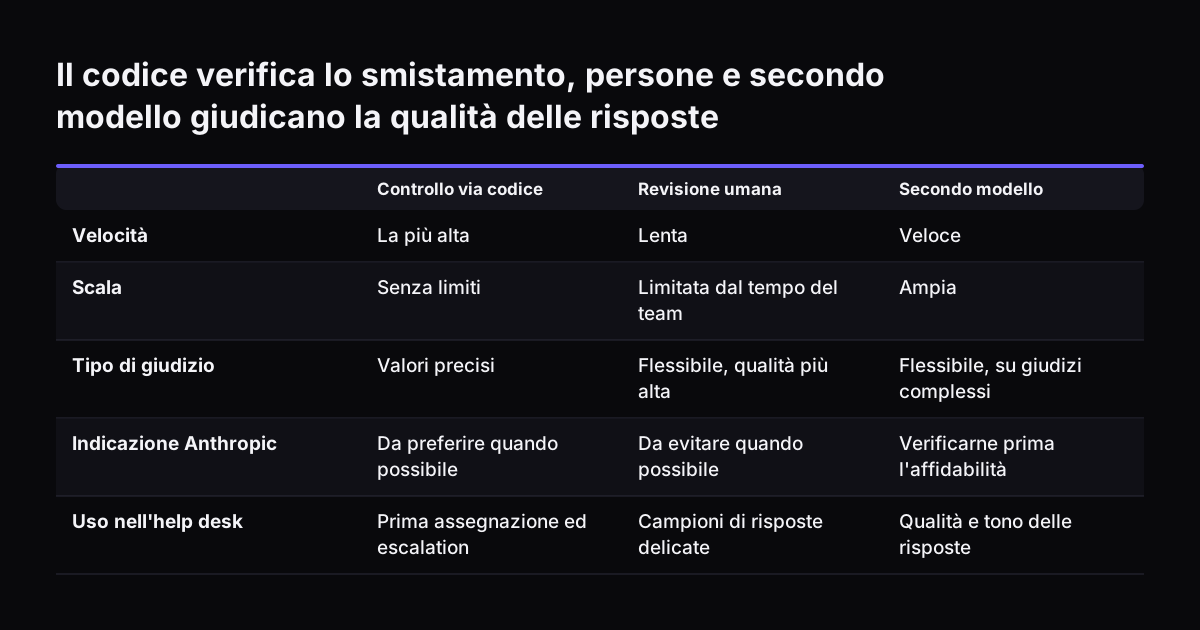
La valutazione delle risposte di un assistente AI si fa in tre modi, e la documentazione di Anthropic ne descrive pregi e limiti. La scelta dipende dalla metrica: lo smistamento si controlla con il codice, la qualità di una risposta richiede un giudizio.

Controllo via codice

Il controllo via codice è il metodo più veloce e affidabile e scala senza limiti. Gli manca però la sfumatura per i giudizi complessi. È adatto alla prima assegnazione corretta e al conteggio delle escalation, dove la risposta giusta è un valore preciso.

Revisione umana

La revisione umana è il metodo più flessibile e di qualità più alta, ma è lenta e costosa. La documentazione consiglia di evitarla quando possibile. In un help desk resta utile su un piccolo campione, per tarare gli altri metodi.

Valutazione con un modello linguistico

Un modello linguistico può valutare le risposte in modo veloce, flessibile e scalabile, anche su giudizi complessi come il tono o la completezza. La documentazione raccomanda di verificarne l'affidabilità prima di estenderlo. Consiglia anche di chiedere al modello di ragionare prima di assegnare il punteggio e di scartare poi il ragionamento. In generale è buona pratica usare per la valutazione un modello diverso da quello che ha prodotto la risposta.

La documentazione aggiunge un criterio di quantità: molte domande con una valutazione automatica un po' meno precisa sono preferibili a poche domande valutate a mano. Per un help desk questo favorisce un set di test ampio, estratto dai ticket reali.

Il codice verifica lo smistamento, persone e secondo modello giudicano la qualità delle risposte. Controllo via codice / Revisione umana / Secondo modello. Velocità: La più alta / Lenta / Veloce; Scala: Senza limiti / Limitata dal tempo del team / Am

Cosa significa per un'azienda italiana: lingua delle risposte e dati personali nei registri

Per un'azienda italiana, misurare un assistente AI pone due questioni specifiche: la lingua in cui l'assistente risponde e i dati personali contenuti nei registri delle conversazioni.

Lingua delle risposte

La documentazione di Anthropic sul supporto multilingue spiega che Claude deduce la lingua dalla conversazione. Per le applicazioni in produzione raccomanda però di indicarla esplicitamente nel prompt di sistema, che mantiene l'istruzione stabile in ogni turno. Se l'utente sceglie la lingua, la scelta va inserita nel prompt di sistema invece di lasciarla dedurre.

Se il Suo help desk serve clienti in più lingue, conviene calcolare le metriche separatamente per lingua. La documentazione segnala infatti che le prestazioni variano da una lingua all'altra.

Dati personali nei registri

Un dato personale è qualsiasi informazione su una persona fisica identificata o identificabile, secondo l'art. 4 del Regolamento (UE) 2016/679 richiamato dal Garante. Le conversazioni di un help desk ne contengono quasi sempre.

Il Garante ha sanzionato con 1.000 euro l'Istituto Comprensivo di Roverbella (provvedimento n. 732 del 4 dicembre 2025). L'istituto aveva inviato a più famiglie un'e-mail di sollecito sugli adempimenti vaccinali, con gli indirizzi in chiaro. Il Garante l'ha considerata una comunicazione a terzi di dati personali, compresi dati relativi alla salute di alunni minori. Il caso mostra che anche un errore materiale conta.

Il principio di minimizzazione dell'art. 5, par. 1, lett. c), del Regolamento (UE) 2016/679 richiede di trattare solo i dati necessari alla finalità. Per le metriche bastano quindi campi strutturati, non il testo integrale di ogni conversazione. Il quadro generale è nella pagina sul quadro normativo AI in Italia.

Prossimi passi: scrivere le metriche prima di scegliere lo strumento

Il primo passo concreto è scrivere su una pagina le tre metriche, con il valore di partenza di ciascuna. Questo lavoro precede qualsiasi discussione su modelli o fornitori. Se il valore di partenza non si riesce a calcolare oggi, quella è la prima cosa da sistemare nel Suo help desk.

Una sequenza pratica per le prossime settimane:

  1. Estrarre i ticket chiusi di un periodo normale e contare quelli riassegnati dopo il primo smistamento.
  2. Calcolare il tempo medio di gestione per categoria sullo stesso periodo.
  3. Elencare i casi che le regole interne riservano a una persona, per definire le escalation corrette.
  4. Aggiungere al ticket i campi descritti in questa guida, a partire dal reparto proposto.
  5. Scrivere i criteri di successo con soglie e responsabile della verifica.

Se l'assistente è il primo progetto AI dell'azienda, conviene delimitarne il perimetro. Il post sul primo progetto AI in azienda, tra scelta, pilota e costi spiega come farlo. Per capire da dove partire con i dati e i processi che ha già, può compilare la valutazione di prontezza all'AI. Le risposte indicano quali delle tre metriche il Suo team può misurare fin da subito.

Fonti

  1. 1. Anthropic, Define success criteria and build evaluations
  2. 2. Anthropic, Multilingual support
  3. 3. Garante per la protezione dei dati personali, provvedimento n. 732 del 4 dicembre 2025

Articoli correlati