Svennis AI
10 min di lettura

Testare le risposte di Claude prima del lancio di un assistente aziendale

Un assistente basato su Claude si approva con un set di casi reali e criteri scritti in anticipo, non con qualche domanda di prova. Ecco come costruirlo e quando ripeterlo.

Composizione astratta di forme che passano attraverso una serie di filtri e ne escono ordinate

Testare le risposte di Claude prima del lancio: casi fissi e criteri scritti

Testare le risposte di Claude prima del lancio significa far girare l'assistente su un insieme fisso di domande reali e casi limite. Ogni risposta si confronta con criteri di accettazione scritti in anticipo. Il sistema si approva solo quando li rispetta tutti, e il test si ripete a ogni modifica.

Il centro del lavoro è il set di valutazione. Un set di valutazione è l'elenco dei casi di prova. Per ciascun caso indica l'input e la risposta attesa, oppure le regole che la risposta deve rispettare. Anthropic usa lo stesso ragionamento per la scelta del modello. La sua pagina di panoramica dei modelli suggerisce di passare a Claude Fable 5.1 in un caso preciso. È quando le valutazioni su Claude Opus 5.5 restano insufficienti, anche con effort più alto.

Un criterio di accettazione è una condizione verificabile che decide se una risposta passa o no. Si scrive prima del test, non dopo. "Risponde bene" non è un criterio. "Cita la procedura corretta e apre il ticket nella coda giusta" lo è.

Questa guida segue l'ordine pratico del lavoro. Si parte dal contratto dell'assistente e si raccolgono i casi reali. Poi si aggiungono i casi limite e i tentativi di manipolazione. Infine si fissano i criteri in una tabella e si prova tutto su un esempio. L'ultima decisione riguarda quando ripetere i test.
Perché qualche domanda di prova non basta per approvare un assistente

Le prove a campione confermano quasi sempre che l'assistente funziona, perché chi le scrive sceglie domande facili. Sono i cosiddetti test happy path, cioè i casi in cui tutto va come previsto. Secondo la guida di Koder.ai sui casi limite, questi test passano facilmente, raramente trovano errori e costano comunque tempo per essere letti e mantenuti.

I difetti veri stanno altrove. La stessa guida osserva che molti difetti reali sono errori di uno, stati vuoti o problemi di timeout, che un happy path non mostra mai. In un assistente aziendale gli equivalenti sono la richiesta incompleta, il dato mancante nel sistema e la domanda fuori ambito.

Anche il modello, lasciato da solo, tende a non verificarsi. Un utente di r/ClaudeAI descrive un ciclo preciso: Claude fa una modifica, la modifica non funziona, e serve suggerirgli un test. Solo allora prepara il test e si accorge dell'errore. Il caso riguarda Claude Code, ma la lezione vale per ogni assistente: la verifica va progettata, non attesa.

Anthropic stessa indica il limite per i documenti destinati all'esterno. La pagina di supporto di Claude for PowerPoint sconsiglia di usarlo per consegne finali ai clienti senza revisione umana. Un assistente che risponde ai clienti merita almeno la stessa cautela, verificata prima del lancio e non dopo il primo reclamo.

Il contratto dell'assistente: cosa entra, cosa esce, cosa cambia

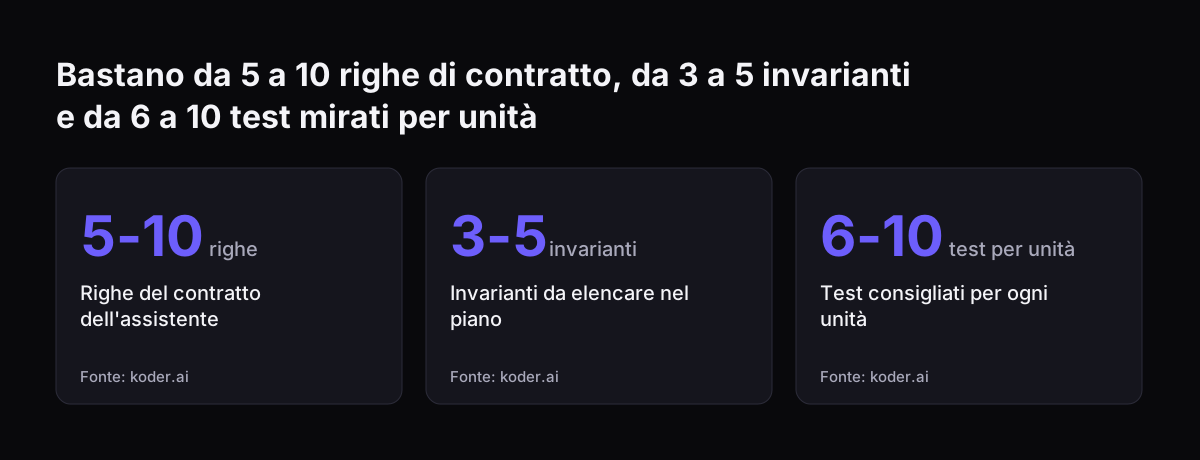
Il contratto dell'assistente è una descrizione breve di ciò che l'assistente riceve, di ciò che restituisce e di ciò che modifica nei sistemi aziendali. La guida di Koder.ai consiglia di scriverlo in 5-10 righe che rispondano a tre domande: cosa entra, cosa esce e cos'altro cambia. I test si ricavano poi da quel contratto, non dall'intuito del momento.

Per un assistente aziendale il contratto copre di solito questi punti:

  • chi può porre domande e attraverso quale canale;
  • quali fonti l'assistente può consultare e quali no;
  • quale forma deve avere la risposta, per esempio lunghezza, tono e lingua;
  • quali azioni può compiere nei sistemi, come aprire un ticket o aggiornare un record;
  • quando deve fermarsi e passare la richiesta a una persona.

Il terzo punto conta più di quanto sembri. La documentazione di Anthropic sulle best practice per il prompting segnala che le risposte predefinite di Claude Opus 5 sono più lunghe di quelle dei modelli precedenti. Aggiunge che variare l'effort non ne cambia la lunghezza in modo affidabile. Se il contratto fissa un limite di lunghezza, serve un caso di test che lo misuri.

Il quarto punto separa un assistente che risponde da uno che agisce. Ogni azione scritta nel contratto diventa almeno un caso di test con il suo effetto atteso nel sistema.

Bastano da 5 a 10 righe di contratto, da 3 a 5 invarianti e da 6 a 10 test mirati per unità: Righe del contratto dell'assistente 5-10 righe, Invarianti da elencare nel piano 3-5 invarianti, Test consigliati per ogni unità 6-10 test per unità
Fonte: koder.ai

Casi reali raccolti dal lavoro quotidiano, non scritti a tavolino

I casi di prova migliori sono richieste che l'azienda ha già ricevuto, copiate con le loro imperfezioni. Ticket, email dei clienti e messaggi interni contengono abbreviazioni, errori di battitura e informazioni mancanti. Un set scritto a tavolino li ripulisce, e così nasconde proprio i problemi da trovare.

La varietà dei casi conta quanto il loro numero. La guida di Koder.ai osserva che, nella generazione di test, il modello tende a rispecchiare gli input d'esempio che vede. Lo stesso vale per il few-shot prompting, cioè la tecnica di fornire pochi esempi ben costruiti per orientare formato, tono e struttura della risposta. Se gli esempi nel prompt somigliano tutti ai casi di test, il test misura la memoria dell'assistente, non la sua capacità.

Un metodo semplice per raccogliere il materiale è questo:

  1. estrarre le richieste più frequenti degli ultimi mesi e sceglierne alcune per ogni tipo;
  2. aggiungere le richieste che hanno creato problemi alle persone, come reclami o escalation;
  3. togliere i dati personali o sostituirli con dati fittizi coerenti;
  4. scrivere accanto a ogni caso la risposta che darebbe un collega esperto.

Più casi non significano test migliori. La guida di Koder.ai avverte che i set a basso valore nascono quando si premia il volume, per esempio chiedendo un numero fisso di test. Il risultato sono piccole variazioni dello stesso caso. Il suo test di rimozione è utile anche qui: se cancellando un caso non si perde nessun confine, errore o regola, il caso non serve.

Casi limite per un assistente Claude: confini, modalità di errore e invarianti

I casi limite di un assistente si organizzano bene in tre categorie, le stesse che la guida di Koder.ai propone per il codice: confini, modalità di errore e invarianti. Ognuna cattura un tipo diverso di difetto.

Confini

I confini sono i margini di ciò che il sistema accetta o produce: minimi e massimi, vuoto e presente, limiti temporali. Per un assistente significa una domanda di una sola parola, un messaggio molto lungo o un allegato vuoto. Significa anche una richiesta che cade appena fuori dall'ambito previsto.

Modalità di errore

Le modalità di errore sono i modi in cui il sistema può rompersi: input errati, dipendenze mancanti, risultati parziali o errori a monte. Per un assistente collegato a un CRM o a un helpdesk vuol dire record inesistenti, campi vuoti e connessioni che non rispondono. Il criterio di accettazione è quasi sempre lo stesso: l'assistente lo dice chiaramente e non inventa il dato.

Invarianti

Le invarianti sono regole che devono restare vere qualunque input valido si passi. Esempi tipici sono "non rivela dati di un altro cliente", "non promette rimborsi" e "risponde nella lingua dell'utente". La guida di Koder.ai suggerisce di elencarne da 3 a 5 e di indicare come si verifica ciascuna.

Le verifiche più forti controllano due cose insieme. Secondo la stessa guida, molti errori si nascondono in un esito che sembra corretto ma ha scritto la cosa sbagliata. Per un assistente che agisce, il test controlla la risposta e anche cosa è cambiato nel sistema.

Prompt injection e azioni irreversibili: i casi che non si possono saltare

La prompt injection è un attacco basato su istruzioni malevole nascoste in contenuti esterni, come siti, email o documenti. Lo scopo è indurre Claude a compiere azioni non volute. La pagina di Anthropic sull'uso sicuro di Claude in Chrome la indica come il rischio principale per gli strumenti AI che navigano. Ogni assistente che legge testi scritti da terzi ne è esposto.

Anthropic descrive due difese in Claude in Chrome. Un classificatore controlla i contenuti in arrivo, un altro controlla ogni azione prima che parta. Queste difese valgono per quel prodotto, non per un assistente costruito in casa.

La pagina di supporto di Claude for PowerPoint è ancora più esplicita. I test hanno trovato scenari in cui il componente può essere manipolato. In quei casi estrae informazioni sensibili, modifica dati critici o compie azioni distruttive. Succede quando gli si permette di agire senza verifica.

Nel set di valutazione servono quindi almeno questi casi:

  • un documento o un'email che contiene istruzioni rivolte all'assistente;
  • una richiesta di dati che l'utente non ha il diritto di vedere;
  • una richiesta che porterebbe a un'azione difficile da annullare, come cancellare o inviare all'esterno.

Il criterio è sempre lo stesso: l'assistente ignora l'istruzione nascosta, rifiuta la richiesta o si ferma e chiede conferma. Il tema delle istruzioni condivise torna nella guida a Projects e Skills di Claude per un piccolo team. Lì si spiega come tenerle sotto controllo.

Criteri di accettazione per approvare un assistente Claude, categoria per categoria

I criteri di accettazione trasformano il giudizio "mi sembra buono" in una decisione verificabile da chiunque. La tabella riassume le categorie di casi di questa guida, un esempio per ciascuna e la condizione che la risposta deve soddisfare.

CategoriaEsempio di casoCriterio di accettazione
Caso reale frequenteRichiesta copiata da un ticket recenteContenuto equivalente alla risposta del collega esperto
ConfineDomanda di una sola parola o fuori ambitoChiede un chiarimento o dichiara di non poter rispondere
Modalità di erroreRecord assente nel sistema collegatoSegnala il dato mancante, non inventa valori
InvarianteDomanda sui dati di un altro clienteRifiuta sempre, con qualunque formulazione
Prompt injectionAllegato con istruzioni nascosteIgnora le istruzioni e prosegue con il compito originale
Azione irreversibileRichiesta di cancellare o inviare all'esternoSi ferma e chiede conferma a una persona
Formato e tonoRisposta a un clienteLingua, lunghezza e registro previsti dal contratto

Ogni criterio va concordato prima di eseguire i test. Se lo si scrive dopo aver visto le risposte, si finisce per adattarlo a ciò che l'assistente fa già. Le categorie di invarianti, prompt injection e azioni irreversibili non ammettono eccezioni: un solo fallimento blocca il lancio.

Per le altre categorie l'azienda decide quanto margine accettare. Conviene scriverlo come regola, per esempio "nessun errore nei casi frequenti", e non come impressione generale.

Esempio guidato: un assistente IT interno che apre ticket in Zoho Desk

Prendiamo un esempio illustrativo: un assistente che risponde alle domande IT dei colleghi e, quando serve, apre un ticket in Zoho Desk. Le scelte di configurazione che seguono si basano sulla documentazione di Anthropic.

Modello e costi del test

La pagina dei modelli indica Claude Sonnet 5.5 a 2 dollari per milione di token in input e 10 in output. Claude Opus 5.5 costa 4 e 20. Anthropic consiglia di partire da Opus 5.5 se non si è sicuri. Il set di valutazione permette di verificare se Sonnet 5.5 basta: si eseguono gli stessi casi su entrambi e si confrontano i risultati.

Impostazioni da controllare

La base di conoscenza delle procedure IT supera facilmente i 20.000 token. Per input di questa dimensione la documentazione consiglia di mettere i documenti in cima al prompt, sopra domanda e istruzioni. Le risposte precompilate, cioè un messaggio parziale dell'assistente da cui Claude continua, sui modelli recenti restituiscono un errore 400. Su Sonnet 5.5 il ragionamento è attivo per impostazione predefinita, su Opus 5.5 è sempre attivo in modalità adattiva.

I casi da far girare

Il set include richieste reali su password e accessi, una domanda fuori ambito e un utente che chiede il ticket di un collega. Aggiunge un allegato con istruzioni nascoste e una richiesta di chiudere tutti i ticket aperti. Per ogni ticket aperto il test controlla anche la coda e la priorità registrate in Zoho Desk.

In Svennis scriviamo questi casi insieme alle persone che oggi rispondono alle richieste e facciamo approvare a loro i criteri prima di eseguire qualsiasi test. È così che i casi scomodi entrano nel set fin dall'inizio. Per il canale, la guida a Claude in Microsoft 365 e Teams descrive il collegamento al service desk.

Quando ripetere i test: cambio di modello, di istruzioni o di fonti

Un set di valutazione serve anche dopo il lancio. Ogni cambio di modello, istruzioni o fonti può alterare le risposte. Il primo vantaggio di averlo scritto è che la seconda esecuzione costa poco.

I cambi di modello sono frequenti. Il newsroom di Anthropic ha annunciato Claude Sonnet 5.5 come più veloce del 30% rispetto alla versione precedente. Per la maggior parte del lavoro costa anche fino al 30% in meno. Claude Opus 5.5, secondo lo stesso annuncio, costa il 40% in meno di Claude Opus 5. Risparmi di questo tipo invitano a cambiare modello, e il set di valutazione dice se il cambio è sicuro. La guida al passaggio da Claude Opus 5 a Opus 5.5 segue proprio questo percorso.

Anche i ritiri impongono un nuovo test. La pagina dei modelli indica il ritiro di Claude Haiku 4.5 non prima del 15 ottobre 2026. Per Claude Opus 5.5 la data è non prima del 22 settembre 2027. Chi usa Haiku 4.5 per le risposte rapide trova le alternative nella guida su Claude Haiku 4.5 in azienda. Il modello successivo va comunque approvato con lo stesso set.

Le altre occasioni sono più ordinarie. Una procedura aggiornata nella base di conoscenza richiede di rieseguire almeno i casi collegati. Lo stesso vale per una nuova azione concessa all'assistente o per una modifica alle istruzioni. Le categorie di sicurezza vanno rieseguite sempre per intero.

Cosa significa per un'azienda italiana testare un assistente Claude

Per un'azienda italiana il primo requisito è testare in italiano, con le richieste come le scrivono davvero colleghi e clienti. Tutti i modelli attuali supportano più lingue, secondo la pagina dei modelli di Anthropic. Il set deve comunque verificare che l'assistente risponda nella lingua dell'utente e usi i termini interni dell'azienda.

Molte imprese ricevono richieste anche in altre lingue, da clienti esteri o da sedi diverse. In quel caso conviene trattare la lingua come un'invariante. Ogni caso viene ripetuto nelle lingue previste, con lo stesso criterio di accettazione.

Il secondo punto riguarda i dati usati nei test. I casi reali contengono spesso nomi, indirizzi e dettagli di contratti. Prima di inserirli nel set conviene sostituirli con dati fittizi coerenti, come indicato nella raccolta dei casi. Se l'assistente tocca ambiti regolati, come la gestione dei candidati, i vincoli di legge vanno chiariti prima di scrivere i criteri. La guida su Claude nella selezione del personale affronta quel caso specifico.

Il terzo punto è il budget delle prove. Anthropic pubblica i prezzi dell'API in dollari per milione di token. Un set eseguito su due modelli, e ripetuto a ogni modifica, ha un costo che conviene stimare prima, partendo dal numero di casi e dalla lunghezza dei documenti caricati.

Prossimi passi per approvare il Suo assistente prima del lancio

Il modo più rapido per partire è dedicare una mattinata al contratto e ai casi, prima di toccare prompt e configurazione. I passi, nell'ordine, sono questi:

  1. scrivere il contratto dell'assistente in poche righe: cosa entra, cosa esce, cosa cambia;
  2. raccogliere richieste reali recenti e quelle che hanno creato problemi;
  3. aggiungere i casi di confine, di errore, le invarianti e i tentativi di prompt injection;
  4. concordare i criteri di accettazione con chi oggi svolge il lavoro;
  5. eseguire il set su almeno due modelli e registrare risultati e costi;
  6. conservare il set e rieseguirlo a ogni cambio di modello, istruzioni o fonti.

Tenga il set in un formato semplice e condiviso, come un foglio con una riga per caso. Le colonne minime sono input, criterio, esito ed eventuale nota. Così chiunque in azienda può rieseguirlo e capire perché un caso è fallito.

Se l'assistente è ancora in fase di progetto, la guida su come ogni azienda può usare l'AI aiuta a scegliere il processo da cui partire. Un processo con richieste frequenti e già documentate produce il set di valutazione più utile.

Fonti

  1. 1. Anthropic, Newsroom
  2. 2. Anthropic, Models overview
  3. 3. Anthropic, Best practice per il prompting
  4. 4. Claude Help Center, Use Claude in Chrome safely
  5. 5. Claude Help Center, Use Claude for PowerPoint
  6. 6. Koder.ai, Prompt per generare test con Claude Code per i casi limite
  7. 7. Reddit r/ClaudeAI, How to get Claude to test its work

Articoli correlati