Skip to content
SVENNISAIWe speak Claude.
Blog · Claude API

Costurile API Claude: prompt caching și procesare batch, cu un calcul lunar

Prompt caching și procesarea batch pot reduce mult factura unui agent AI (Claude) din producție. Ghidul arată ce pui în cache, ce trimiți în batch și unde nu merită.

10 min de citit
Articol · 10 min de citit
Straturi abstracte care se repetă și se comprimă, sugerând prompturi refolosite și cereri trimise în grup

Costurile API Claude scad cel mai mult prin prompt caching și procesare batch

La costurile API Claude, prompt caching și procesare batch sunt cele două pârghii care scad cel mai mult factura unui agent din producție. Caching-ul ieftinește partea de prompt care se repetă la fiecare apel. Batch-ul înjumătățește prețul muncii care poate aștepta. În calculul din acest ghid, factura lunară a unui agent de helpdesk scade de la 147 la circa 50 de dolari.

API-ul Claude este accesul programatic la modelele Anthropic și se plătește la consum, pe tokeni. Un agent AI (Claude) este un program care primește o sarcină, citește datele prin unelte și răspunde sau acționează, apelând modelul prin API. Spre deosebire de un abonament cu seat-uri, aici fiecare apel are un cost. Dacă te interesează abonamentele Pro, Max sau Team, le găsești în prețurile Claude în euro.

Ghidul e scris pentru cine plătește factura unui agent construit pe API. Afli cum se facturează tokenii, ce pui în cache, ce trimiți în batch și unde niciuna nu ajută. Toate prețurile vin din paginile Anthropic citite azi. Anthropic le publică în dolari americani, așa că le păstrăm în USD.
Cum se facturează tokenii în API-ul Claude: intrare, ieșire și model

API-ul Claude facturează separat tokenii de intrare și tokenii de ieșire, la un preț pe milion de tokeni care depinde de model. Un token este o bucată de text pe care modelul o procesează. Numărul de tokeni pentru același text depinde de tokenizer, de limbă și de tipul conținutului.

Tokenii de intrare sunt tot ce trimiți la fiecare apel: instrucțiunile, definițiile uneltelor, documentele și istoricul conversației. Tokenii de ieșire sunt textul scris de model. La toate modelele din tabelul de mai jos, un token de ieșire costă de cinci ori cât unul de intrare.

Prețurile standard de pe pagina de prețuri Anthropic, în USD pe milion de tokeni:

ModelIntrareIeșirePentru ce e gândit
Claude Fable 5.2840Raționament dificil și muncă agentică de durată
Claude Opus 5.5420Programare agentică de durată și muncă de cunoaștere
Claude Sonnet 5.5210Cea mai bună combinație de viteză și inteligență
Claude Haiku 5.5de la 0,10de la 0,50Volum mare: clasificare, extragere, rutare

Două detalii schimbă calculul. Anthropic notează că modelele mai noi folosesc un tokenizer care produce cu aproximativ 30% mai mulți tokeni pentru același text. Fereastra de context de 1 milion de tokeni vine la preț standard, cu excepția Haiku 5.5. La Haiku 5.5, prețul de 0,10 USD se aplică prompturilor de până la 100.000 de tokeni.

Uneltele de pe serverul Anthropic au costuri proprii. Căutarea web costă 10 USD la 1.000 de căutări, plus tokenii. Web fetch nu are cost suplimentar. Alegerea modelului rămâne prima pârghie: Anthropic spune că Opus 5.5 costă cu 40% mai puțin decât Opus 5 la sarcinile obișnuite. Detaliile sunt în ghidul despre migrarea la Claude Opus 5.5.

Prompt caching: o scriere puțin mai scumpă, apoi citiri aproape gratuite

Prompt caching este funcția prin care API-ul reia lucrul de la un început de prompt deja procesat, în loc să-l proceseze din nou la preț întreg. La primul apel plătești o scriere în cache. La apelurile care încep identic plătești o citire, mult mai ieftină.

Scrierea costă cu 25% mai mult decât intrarea standard, pentru durata implicită de 5 minute. O durată de o oră costă dublul prețului de intrare la scriere. Citirea costă în general 10% din prețul de intrare. Pe Opus 5.5 și Sonnet 5.5, citirea costă doar 0,05 din prețul de intrare.

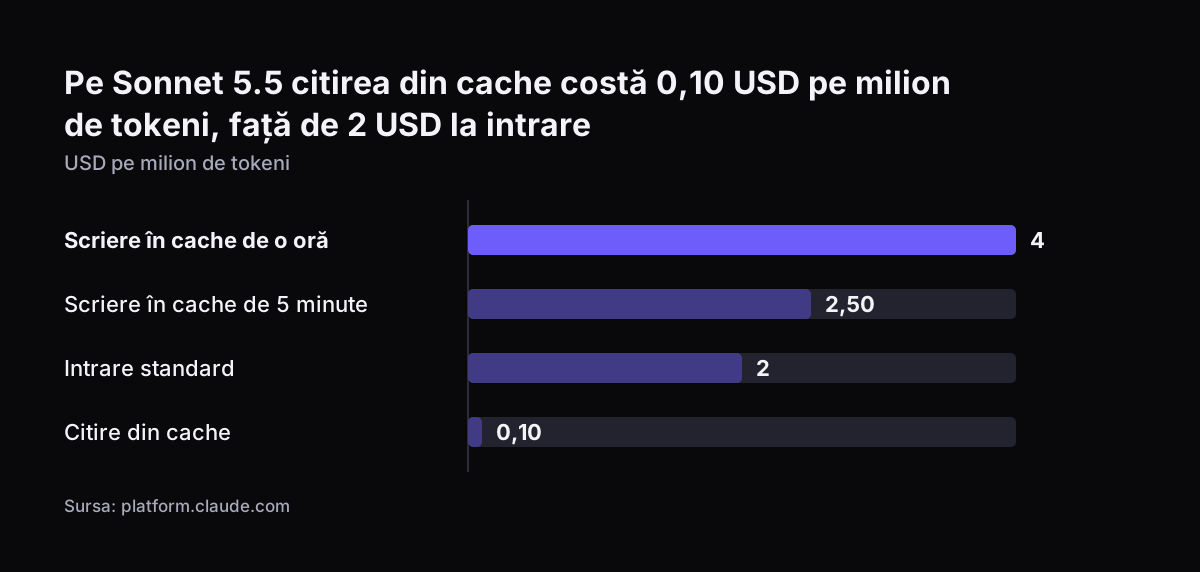
Pe Sonnet 5.5, asta înseamnă 2 USD pe milion de tokeni la intrare standard și 2,50 USD la scrierea de 5 minute. Scrierea de o oră costă 4 USD, iar citirea 0,10 USD. Pe Opus 5.5, aceleași patru prețuri sunt 4, 5, 8 și 0,20 USD.

Durata de 5 minute se reînnoiește gratuit la fiecare folosire. De aceea Anthropic spune că, la durata de 5 minute, caching-ul se plătește deja după o singură citire. Durata de o oră merită când între două folosiri ale aceluiași prefix trec mai mult de cinci minute. Calculul e explicat într-o analiză m2ml despre cele două durate de cache, listată la surse.

Prompt caching nu schimbă răspunsul. Primești exact ce ai fi primit fără cache. Citirile din cache nu se scad din limita de rată, iar marcajele de cache nu costă nimic în sine. Plătești doar scrierile, citirile și tokenii de intrare care nu sunt în cache.

Pe Sonnet 5.5 citirea din cache costă 0,10 USD pe milion de tokeni, față de 2 USD la intrare: Scriere în cache de o oră 4, Scriere în cache de 5 minute 2,50, Intrare standard 2, Citire din cache 0,10 (USD pe milion de tokeni)
Sursa: platform.claude.com

Ce pui în cache la un agent: uneltele, instrucțiunile și documentele fixe

În prompt caching pui tot ce rămâne identic de la un apel la altul, iar ordinea din prompt decide ce se poate refolosi. Câmpul cache_control marchează sfârșitul blocului din cache. Tot ce stă înainte, inclusiv acel bloc, devine cheia cache-ului.

Ordinea care funcționează la un agent din producție:

  1. definițiile uneltelor prin care agentul citește din CRM, helpdesk sau facturare;
  2. instrucțiunile de sistem: rolul, tonul, regulile de escaladare;
  3. documentele fixe: proceduri, liste de prețuri, articole din baza de cunoștințe;
  4. abia la final partea variabilă: tichetul, întrebarea clientului, data curentă.

Documentele fixe merită ținute stabile, nu rescrise zilnic. Cum le organizezi e explicat în ghidul despre o bază de cunoștințe pentru Claude.

Ai două feluri de a marca prefixul. Caching-ul automat cere un singur câmp cache_control la nivelul cererii. Sistemul pune marcajul pe ultimul bloc eligibil și îl mută înainte pe măsură ce conversația crește. Marcajele explicite stau direct pe blocuri, maximum 4 pe cerere.

Două greșeli anulează economia. Un câmp dinamic pus înaintea marcajului, ca ora sau un id de utilizator, schimbă cheia și plătești scrierea la fiecare apel. Orice modificare la definițiile uneltelor invalidează tot cache-ul. La Svennis, după lansarea unui agent urmărim în fiecare răspuns câmpurile cache_creation_input_tokens și cache_read_input_tokens. Când scrierile nu scad după primele ore, căutăm întâi un câmp dinamic urcat înaintea marcajului.

Dacă primul utilizator al dimineții nu trebuie să aștepte, poți încălzi cache-ul dinainte. O cerere cu max_tokens: 0 scrie cache-ul și se întoarce fără să genereze text.

Procesarea batch: jumătate de preț pentru munca ce poate aștepta

Procesarea batch înseamnă să trimiți multe cereri odată și să primești rezultatele mai târziu, la jumătate din prețul standard. Message Batches API este implementarea Anthropic. Procesează asincron volume mari de cereri, iar reducerea de 50% se aplică și la intrare, și la ieșire.

Pe Sonnet 5.5, batch-ul costă 1 USD la intrare și 5 USD la ieșire, pe milion de tokeni. Pe Opus 5.5 costă 2 și 10 USD. Toate modelele active acceptă batch.

Regulile care contează când planifici:

  • Majoritatea batch-urilor se termină în mai puțin de o oră.
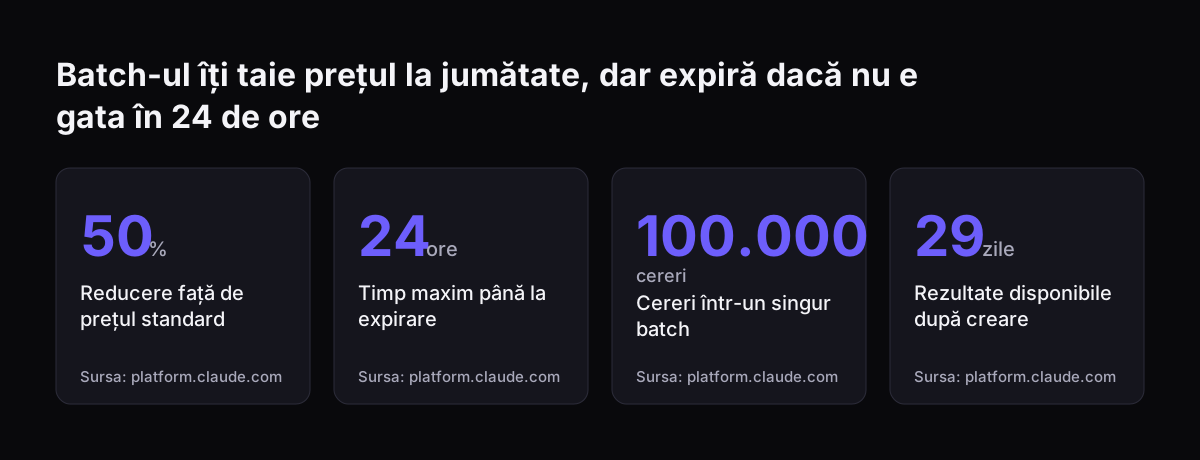
  • Un batch expiră dacă nu e gata în 24 de ore.
  • Un batch are cel mult 100.000 de cereri sau 256 MB, ce se atinge primul.
  • Fiecare cerere poartă un custom_id, cu care potrivești rezultatul cu înregistrarea ta.
  • Rezultatele se pot descărca 29 de zile de la creare.
  • Cererile cu eroare, anulate sau expirate nu se facturează.
  • Batch-ul nu consumă din limitele de rată ale Messages API, deci nu încetinește agentul live.

Batch-ul și prompt caching se pot cumula. În batch, citirile din cache vin însă fără garanție. Anthropic indică rate de reușită între 30% și 98%, după tipul de trafic.

Candidații buni într-o firmă sunt sarcinile de noapte. Exemple: reclasificarea istoricului din Zoho CRM, rezumatele tichetelor pentru raportul de luni, extragerea câmpurilor din documentele adunate peste zi.

Batch-ul îți taie prețul la jumătate, dar expiră dacă nu e gata în 24 de ore: Reducere față de prețul standard 50 %, Timp maxim până la expirare 24 ore, Cereri într-un singur batch 100.000 cereri, Rezultate disponibile după creare 29 zile
Sursa: platform.claude.com

Unde nu merită prompt caching sau procesare batch

Prompt caching și procesarea batch nu ajută peste tot. În câteva cazuri cresc factura sau strică experiența utilizatorului. Cazurile de evitat:

  • Prompt prea scurt. Sub lungimea minimă, cererea merge fără cache și nu primești eroare. Pe Haiku 4.5, minimul e 4.096 de tokeni.
  • Trafic rar, cu durata de 5 minute. Dacă apelurile vin rar, plătești scrierea mai scumpă cu 25% și nu citești niciodată.
  • Prompt care se schimbă la început. Orice diferență înaintea marcajului înseamnă o scriere nouă.
  • Unelte modificate des. Fiecare schimbare de nume, descriere sau parametri golește cache-ul.
  • Conversații live. Clientul de pe site nu așteaptă un batch care poate dura până la 24 de ore. Batch-ul nici nu acceptă stream.
  • Date care nu trebuie păstrate. Batch-ul păstrează cererile și răspunsurile până la 29 de zile și nu e eligibil pentru zero data retention.
  • Fast mode. Nu funcționează cu Batch API.

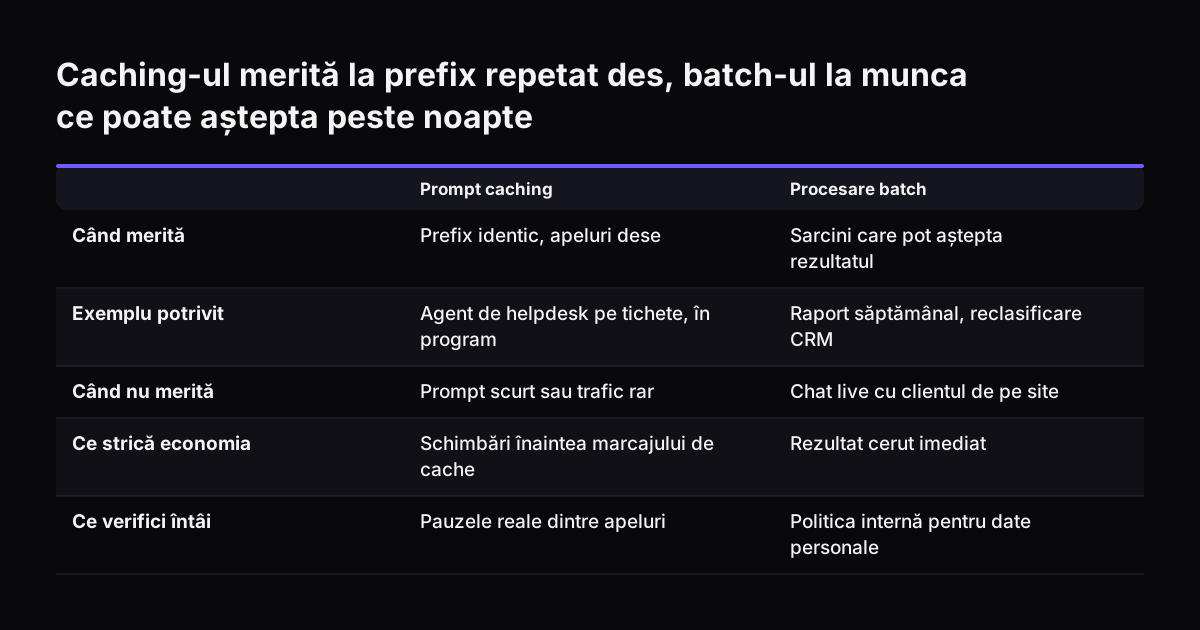
Regula practică e simplă. Cache pentru ce se repetă des, batch pentru ce poate aștepta, apel standard pentru rest. Dacă o sarcină nu intră în niciuna, problema e de obicei modelul ales, nu tehnica.

Caching-ul merită la prefix repetat des, batch-ul la munca ce poate aștepta peste noapte. Prompt caching / Procesare batch. Când merită: Prefix identic, apeluri dese / Sarcini care pot aștepta rezultatul; Exemplu potrivit: Agent de helpdesk pe tichet

Tabel de decizie: caching, batch sau apel standard, pe tipuri de sarcini

Alegerea între prompt caching, procesare batch și apelul standard depinde de două lucruri: cât de des se repetă prefixul și cât poate aștepta rezultatul. Tabelul de mai jos pune sarcinile obișnuite ale unei firme pe aceste două axe.

SarcinăPrompt cachingBatchDe ce
Chat live pe site, mulți vizitatoriDa, 5 minuteNuPrefix comun, răspuns imediat
Agent de helpdesk pe tichete, în programDa, 5 minute sau o orăNuPauzele dintre tichete decid durata
Raport săptămânal pentru conducereOpționalDaPoate rula peste noapte
Reclasificarea istoricului din CRMDa, fără garanțieDaVolum mare, aceleași instrucțiuni
Clasificare și rutare cu volum mareDaDa, dacă nu e urgentăBun candidat pentru Haiku 5.5
Câteva apeluri pe zi, prompt scurtNuNuSub minim sau prea rar

Coloana de caching are întotdeauna aceeași condiție: prefixul trebuie să fie identic și destul de lung. Coloana de batch are și ea una: nimeni nu așteaptă rezultatul în timp real. Când ambele sunt îndeplinite, reducerile se cumulează.

Calcul lunar: un agent de helpdesk pe Sonnet 5.5, cu și fără cache

Un agent de helpdesk pe Sonnet 5.5 cu 3.000 de tichete pe lună costă în exemplul nostru 147 USD fără cache și circa 50 USD cu cache de o oră. Agentul răspunde la tichete în Zoho Desk. Ipotezele de volum sunt ale noastre, ca exemplu. Prețurile sunt cele de pe paginile Anthropic.

Ipotezele de lucru:

  • prefix fix de 20.000 de tokeni: unelte, instrucțiuni, proceduri;
  • 2.000 de tokeni variabili pe tichet și 500 de tokeni de răspuns;
  • cu cache de 5 minute, 20% din apeluri sunt scrieri, din cauza pauzelor;
  • cu cache de o oră, circa o scriere pe oră de program, adică 220 pe lună.
ScenariuPrefix fixIntrare variabilăIeșireTotal lunar
Fără cache120,00 USD12 USD15 USD147,00 USD
Cache de 5 minute34,80 USD12 USD15 USD61,80 USD
Cache de o oră23,16 USD12 USD15 USD50,16 USD

Prefixul cu cache de 5 minute înseamnă 600 de scrieri la 2,50 USD și 2.400 de citiri la 0,10 USD, pe milion de tokeni. Cu durata de o oră, ai 220 de scrieri la 4 USD și 2.780 de citiri. Ieșirea rămâne 15 USD peste tot, pentru că prompt caching nu atinge tokenii de ieșire.

Batch-ul se vede pe sarcinile de volum. Reclasificarea a 50.000 de înregistrări din CRM, cu 1.500 de tokeni la intrare și 150 la ieșire fiecare, costă 225 USD standard pe Sonnet 5.5. În batch costă 112,50 USD. Proporția reală a scrierilor o afli din câmpurile răspunsului, după prima săptămână.

Ce înseamnă costurile API Claude pentru o firmă din România

Pentru o firmă din România, factura API vine în dolari, iar bugetul se face în lei sau euro. Pune în buget o marjă pentru curs. Calculul pe tokeni rămâne valabil, doar conversia se mișcă.

Limba contează la numărul de tokeni. Anthropic spune că numărul depinde de limbă și de tipul conținutului. Nu estima din texte în engleză: rulează câteva tichete reale în română și citește numărul de tokeni din răspuns.

Trei setări merită verificate înainte de lansare:

  • Inferența doar în SUA, prin parametrul inference_geo, înmulțește toate prețurile cu 1,1. Activeaz-o doar dacă ai un motiv clar.
  • Batch-ul păstrează datele până la 29 de zile. Verifică politica ta internă înainte să trimiți date personale din tichete.
  • Cache-urile sunt izolate între organizații. O altă firmă nu îți poate citi prefixul, chiar dacă folosește același prompt.

Uneltele intră și ele în cost. Definiția fiecărui connector, de la MCP server-ul factureaza.ro la un connector construit pentru SmartBill, se trimite la fiecare apel ca tokeni de intrare. De aceea uneltele stau primele în cache și se schimbă rar. Când conectăm Claude la programele unei firme, construim pentru fiecare legătură un connector, un MCP server, un plugin sau un skill. Arătăm opțiunile cu costul lor, iar clientul alege.

Pașii următori pentru a reduce factura API a agentului tău

Primul pas pentru a reduce costurile API Claude este să măsori o săptămână de consum real. Fără cifre, nu știi dacă problema e prefixul, ieșirea sau modelul. Apoi lucrezi în ordinea de mai jos.

  1. Notează din fiecare răspuns tokenii de intrare, de ieșire și câmpurile de cache.
  2. Mută uneltele, instrucțiunile și documentele fixe la începutul promptului.
  3. Scoate orice câmp dinamic de dinaintea marcajului cache_control.
  4. Alege durata cache-ului după pauzele reale dintre apeluri.
  5. Listează sarcinile care pot aștepta peste noapte și mută-le în batch.
  6. Refă calculul lunar cu prețurile zilei de pe pagina Anthropic.

Dacă vrei să faci asta pe un proces real, Pilot Claude A pune un agent AI (Claude) pe API pentru un singur proces. Pilotul este al doilea pas din patru: Workshop, Pilot Claude A sau Pilot Claude B, Activarea departamentului, apoi operarea lunară. Costul fiecărui pas îl găsești pe pagina de prețuri Svennis.

Surse

  1. Pricing - Claude Platform Docs
  2. Batch processing - Claude Platform Docs
  3. Prompt caching - Claude Platform Docs
  4. Models overview - Claude Platform Docs
  5. Newsroom, Anthropic
  6. Claude Prompt Caching: 1-Hour TTL vs 5-Minute TTL Cost Breakdown, m2ml
Gratuit, 30 de minute

Alege o oră. Vino cu procesul la care te-ai gândit citind articolul.

Pleci cu un da sau un nu la automatizare și cu prețul de pe scara publicată. Vorbești cu cine construiește agenții, nu cu un agent de vânzări.

Preferi să suni? +40 722 945 189 · Încă nu vrei să vorbim? Vezi întâi pe firma ta.

30 de minute · apel video · gratuit
  1. 1Ora
  2. 2Datele tale
  3. 3Programat