Zum Inhalt springen
SVENNISAIWe speak Claude.
Blog · Claude Batch API

Massenverarbeitung mit der Claude Batch API: Zoho-Daten günstig im Stapel verarbeiten

Die Claude Batch API verarbeitet große Datenmengen zum halben Preis, mit Ergebnissen spätestens nach 24 Stunden. Der Leitfaden zeigt Ablauf, Grenzen, Kosten und ein Beispiel mit Zoho Desk.

10 Min. Lesezeit
Beitrag · 10 Min. Lesezeit
Abstrakte Komposition aus vielen gleichförmigen Elementen, die sich zu geordneten Stapeln sammeln und weiterfließen

Claude Batch API: halber Preis gegen Ergebnisse innerhalb von 24 Stunden

Massenverarbeitung mit der Claude Batch API lohnt sich, wenn Sie Tausende gleichartiger Aufgaben haben und niemand sofort auf die Antwort wartet. Sie reichen Tickets, Leads oder Dokumente als Stapel ein und zahlen 50 Prozent der regulären API-Preise. Die Ergebnisse erhalten Sie meist in unter einer Stunde, spätestens nach 24 Stunden.

Die Claude Batch API, offiziell Message Batches API, ist die Schnittstelle von Anthropic, über die Sie viele Anfragen an Claude gebündelt einreichen und asynchron verarbeiten lassen. Asynchron heißt: Sie senden den Stapel ab, Ihr System arbeitet weiter, und Sie holen die Antworten später ab. Jede Anfrage im Stapel wird unabhängig von den anderen bearbeitet.

Für Unternehmen mit Zoho gibt es typische Kandidaten. Dazu gehören die nächtliche Neuzuordnung offener Tickets in Zoho Desk, die Bewertung eines Lead-Bestands in Zoho CRM oder die Auswertung eines Dokumentenarchivs. Entscheidend ist immer die Frage, ob der Vorgang warten kann. Wer am Telefon oder im Chat auf eine Antwort wartet, braucht weiterhin Echtzeitanfragen.
Ablauf eines Stapels: einreichen, Status abfragen, Ergebnisse abholen

Ein Stapel in der Claude Batch API durchläuft drei Schritte. Zuerst senden Sie alle Anfragen gemeinsam an den Endpunkt POST /v1/messages/batches. Jede Anfrage ist ein Objekt aus custom_id und params. Das Feld params enthält eine gewöhnliche Messages-API-Anfrage mit Modell, max_tokens und Nachrichten. Die Verarbeitung beginnt sofort nach dem Anlegen.

Danach fragen Sie den Status in Abständen ab, ein Verfahren namens Polling. Der Abrufendpunkt ist idempotent, er liefert also bei jeder Abfrage den aktuellen Zustand, ohne etwas zu verändern. Das Feld processing_status zeigt in_progress, canceling oder ended. Die Zähler für erfolgreiche, fehlerhafte, abgebrochene und abgelaufene Anfragen bleiben bei null, bis der gesamte Stapel fertig ist.

Zuletzt laden Sie die Ergebnisse über die Adresse im Feld results_url. Sie kommen als .jsonl-Datei, also eine JSON-Zeile pro Anfrage. Nachgelagerte Schritte sollten laut OpenRelay erst starten, wenn der Status ended erreicht ist.

Die Reihenfolge der Ergebnisse entspricht nicht der Reihenfolge Ihrer Anfragen. Die custom_id ist deshalb Ihr Schlüssel zurück zum Datensatz. Sie muss im Stapel eindeutig sein, darf 1 bis 64 Zeichen lang sein und nur Buchstaben, Ziffern, Bindestriche und Unterstriche enthalten. Setzen Sie dort die Ticket- oder Lead-ID aus Zoho ein.

Grenzen der Batch API: Stapelgröße, Laufzeit, Aufbewahrung und Werkzeuge

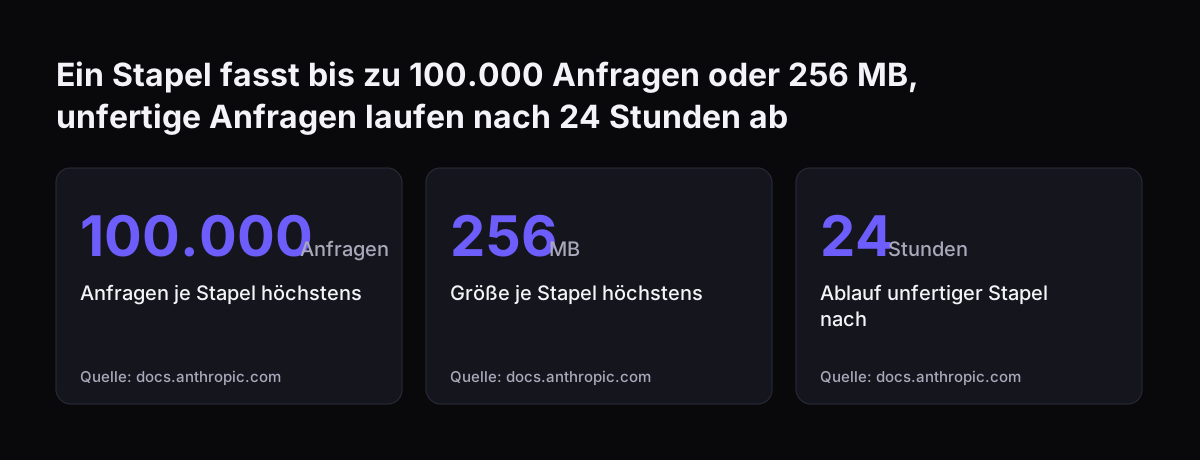
Ein einzelner Stapel umfasst höchstens 100.000 Anfragen oder 256 MB, je nachdem, was zuerst erreicht ist. Größere Bestände teilen Sie auf mehrere Stapel auf. Alle aktiven Claude-Modelle unterstützen die Batch API.

Die Laufzeit hat eine feste Obergrenze. Die meisten Stapel sind laut Anthropic in unter einer Stunde fertig, nach 24 Stunden laufen unfertige Anfragen jedoch ab. Eine garantierte Antwortzeit gibt es nicht. Der Autor von Developers Digest maß im Median 5 bis 30 Minuten, planen sollten Sie trotzdem mit dem schlechtesten Fall. Die Ergebnisse stehen 29 Tage nach Erstellung zum Download bereit.

Ein eingereichter Stapel lässt sich nicht mehr ändern. Bemerken Sie einen Fehler im Prompt, brechen Sie ab und reichen neu ein. Ein Abbruch ist jederzeit vor dem Ende der Verarbeitung möglich. Der Stapel geht dann in den Zustand canceling, in dem laufende Anfragen noch fertig werden können.

Was im Stapel nicht geht

Drei Einschränkungen betreffen den Aufbau der Anfragen:

  • Die Parameter stream, speed (Fast Mode) und max_tokens: 0 führen zu einem Validierungsfehler.
  • Client-Werkzeuge, also Werkzeuge, die Ihr eigener Code ausführt, enden im Stapel bei tool_use. Sie führen das Werkzeug selbst aus und reichen eine Folgeanfrage ein.
  • Server-Werkzeuge wie Websuche oder Codeausführung laufen laut Claude Certification Guide im Stapel wie synchron. Ein Ergebnis kann mit pause_turn zur Fortsetzung zurückkommen.
Ein Stapel fasst bis zu 100.000 Anfragen oder 256 MB, unfertige Anfragen laufen nach 24 Stunden ab: Anfragen je Stapel höchstens 100.000 Anfragen, Größe je Stapel höchstens 256 MB, Ablauf unfertiger Stapel nach 24 Stunden
Quelle: docs.anthropic.com

Kosten im Stapel: 50 Prozent auf alle Token, kombinierbar mit Prompt Caching

Die Batch API berechnet sämtliche Nutzung mit 50 Prozent der regulären API-Preise. Einen eigenen Tarif müssen Sie dafür nicht buchen, der Rabatt gilt durch die Nutzung des Batch-Endpunkts. Anfragen, die fehlschlagen, abgebrochen werden oder ablaufen, werden nicht berechnet.

Die folgende Tabelle zeigt die aktuellen Modelle mit regulärem Preis und Stapelpreis, jeweils in USD je Million Token für Eingabe und Ausgabe:

ModellRegulär (Eingabe / Ausgabe)Im Stapel (Eingabe / Ausgabe)Einsatz laut Anthropic
Claude Fable 5.110 / 505 / 25anspruchsvolles Schlussfolgern, lange agentische Aufgaben
Claude Opus 5.54 / 202 / 10Startpunkt für die meisten Aufgaben, wenn die Wahl unklar ist
Claude Sonnet 5.52 / 101 / 5beste Kombination aus Tempo und Intelligenz
Claude Haiku 5.5ab 0,10 / ab 0,50ab 0,05 / ab 0,25große, kostensensible Mengen, Klassifizierung, Extraktion, Routing

Prompt Caching ist eine Funktion, bei der Claude einen gleichbleibenden Prompt-Anfang zwischenspeichert, etwa Ihre Kategorienliste, und Wiederholungen günstiger berechnet. Die Rabatte von Caching und Batch lassen sich kombinieren. Cache-Treffer sind im Stapel allerdings nicht garantiert. Anthropic nennt typische Trefferquoten von 30 bis 98 Prozent, je nach Datenverkehr.

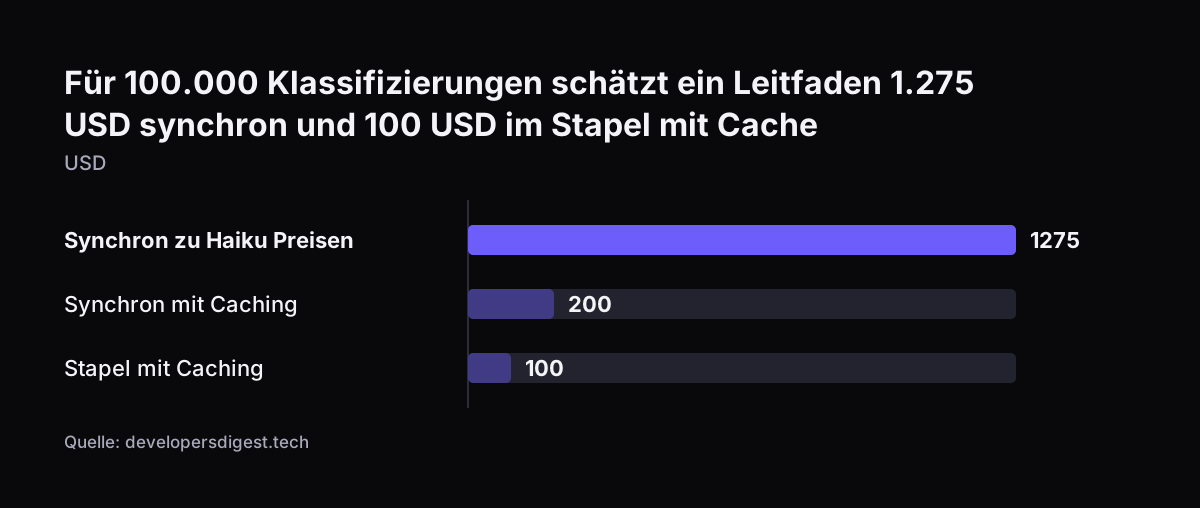
Developers Digest schätzt die Wirkung für 100.000 Klassifizierungen mit je rund 4.000 Eingabe- und 50 Ausgabe-Token zu Haiku-Preisen. Synchron kostet das etwa 1.275 USD, synchron mit Caching etwa 200 USD, im Stapel mit Caching etwa 100 USD. Der Autor nennt auch eine Faustregel: Unter etwa 1.000 Anfragen pro Stapel frisst der Aufwand der asynchronen Verarbeitung die Ersparnis auf.

Für 100.000 Klassifizierungen schätzt ein Leitfaden 1.275 USD synchron und 100 USD im Stapel mit Cache: Synchron zu Haiku Preisen 1275, Synchron mit Caching 200, Stapel mit Caching 100 (USD)
Quelle: developersdigest.tech

Batch oder Echtzeit: entscheidend ist, ob jemand auf das Ergebnis wartet

Echtzeitanfragen, auch synchrone Aufrufe genannt, gehören überall dorthin, wo ein Mensch oder ein Prozess auf die Antwort wartet. Die Batch API gehört zu Aufgaben, deren Ergebnis später genutzt wird. Diese Unterscheidung aus dem Claude Certification Guide zur Stapelverarbeitung ist die einfachste Prüffrage für jeden Anwendungsfall in Zoho.

Die Tabelle ordnet typische Anwendungsfälle ein:

AnwendungsfallWartet jemand?Empfehlung
Kunde schreibt im Chat und erwartet eine AntwortjaEchtzeit
Neues Ticket soll sofort beim richtigen Team landenjaEchtzeit
Offene Tickets über Nacht neu kategorisierenneinBatch
Lead-Bestand einmal pro Woche bewertenneinBatch
Dokumentenarchiv auf Felder wie Vertragsende auswertenneinBatch
Einige Dutzend Datensätze einmalig bearbeitenneinEchtzeit, der Batch-Aufwand lohnt kaum

In der Praxis bewährt sich ein Hybridmuster: synchrone Aufrufe für alles, was Kunden oder Mitarbeitende direkt sehen, Stapel für alles andere. Den Echtzeitweg für eingehende Anfragen beschreibt unser Beitrag zum mehrsprachigen Kundenservice mit Claude in Zoho Desk. Wie Claude einzelne Leads bewertet, zeigt der Beitrag Leads mit Claude in Zoho CRM qualifizieren.

Behalten Sie die Ratenlimits im Blick. Laut Anthropic beeinflusst die Batch-Nutzung die Limits der Messages API nicht. Der Autor von Developers Digest berichtet dagegen, dass ein sehr großer Stapel bei ihm synchrone Aufrufe in overloaded_error laufen ließ. Starten Sie große Stapel daher außerhalb der Geschäftszeiten.

Praxisbeispiel: offene Tickets aus Zoho Desk über Nacht neu klassifizieren

Das Beispiel zeigt einen vollständigen Ablauf für einen Kundenservice mit vielen offenen Tickets, deren Kategorien über die Zeit uneinheitlich geworden sind. Claude schlägt für jedes Ticket eine Kategorie aus einer festen Liste vor. Ein Mensch prüft Stichproben, erst dann ändert sich das Feld in Zoho Desk.

Der Ablauf besteht aus sechs Schritten:

  1. Prompt testen. Prüfen Sie den Prompt an 5 bis 10 repräsentativen Tickets, die die Bandbreite an Formaten und Sonderfällen abdecken.
  2. Abends exportieren. Ein geplanter Ablauf in Zoho Flow oder ein Deluge-Skript sammelt Ticket-ID, Betreff und Beschreibung der offenen Tickets.
  3. Stapel bauen. Jedes Ticket wird eine Anfrage, die Ticket-ID wird zur custom_id.
  4. Einreichen und abfragen. Das Skript sendet den Stapel und fragt den Status ab, bis er ended meldet.
  5. Ergebnisse zuordnen. Über die custom_id landet jeder Vorschlag beim richtigen Ticket, zunächst in einem Prüffeld.
  6. Prüfen und übernehmen. Das Fachteam kontrolliert eine Stichprobe, danach wird der Vorschlag in das Kategoriefeld übernommen.

Für reine Klassifizierung eignet sich Claude Haiku 5.5. Anthropic positioniert dieses Modell für große Mengen, Klassifizierung, Extraktion und Routing. Verlangen Ihre Kategorien viel Kontext, ist Claude Sonnet 5.5 die nächste Stufe. Im Stapel kostet es 1 USD je Million Eingabe-Token und 5 USD je Million Ausgabe-Token.

Request-Body für den Ticket-Stapel mit custom_id und Systemprompt

Der folgende JSON-Body enthält zwei Anfragen eines Ticket-Stapels. Ihr Skript sendet ihn per POST an /v1/messages/batches und erzeugt in der Praxis eine Anfrage pro exportiertem Ticket. Der Systemprompt steht im eigenen Feld system auf oberster Ebene der Anfrage, denn eine Rolle „system“ gibt es bei den Nachrichten nicht.

{
  "requests": [
    {
      "custom_id": "desk-ticket-100231",
      "params": {
        "model": "claude-sonnet-5-5",
        "max_tokens": 50,
        "system": "Wähle genau eine Kategorie: Rechnung, Lieferung, Technik, Sonstiges.",
        "messages": [
          {
            "role": "user",
            "content": "Betreff: Rechnung doppelt erhalten. Die Mai-Rechnung kam zweimal."
          }
        ]
      }
    },
    {
      "custom_id": "desk-ticket-100232",
      "params": {
        "model": "claude-sonnet-5-5",
        "max_tokens": 50,
        "system": "Wähle genau eine Kategorie: Rechnung, Lieferung, Technik, Sonstiges.",
        "messages": [
          {
            "role": "user",
            "content": "Betreff: Paket fehlt. Die Lieferung ist seit einer Woche unterwegs."
          }
        ]
      }
    }
  ]
}

Vier Stellen passen Sie an. In custom_id setzen Sie die echte Ticket-ID ein, im erlaubten Zeichensatz und höchstens 64 Zeichen lang. Unter model tragen Sie die Modell-ID aus der Modellübersicht von Anthropic ein, etwa für Haiku 5.5. Das Feld max_tokens ist Pflicht; für eine Ein-Wort-Antwort genügt ein kleiner Wert. In system steht Ihre eigene Kategorienliste.

Setzen Sie weder temperature noch top_k. Modelle, die nach Claude Opus 4.6 erschienen sind, lehnen jeden Wert für top_k mit einem Fehler 400 ab. Für temperature akzeptieren sie nur noch 1.0.

Ergebnisse geprüft zurückschreiben: vier Ergebniszustände und gezielte Wiederholung

Jede Anfrage eines Stapels endet in genau einem von vier Zuständen, und Ihr Rückschreibskript muss alle vier behandeln:

  • succeeded: Die Antwort liegt vor und geht in die Prüfung.
  • errored: Die Anfrage ist fehlgeschlagen, etwa durch einen Validierungsfehler.
  • canceled: Der Stapel wurde abgebrochen, bevor die Anfrage verarbeitet wurde.
  • expired: Die Anfrage wurde innerhalb von 24 Stunden nicht fertig.

Fehler betreffen einzelne Anfragen, nicht den ganzen Stapel. Reichen Sie deshalb nur die fehlgeschlagenen und abgelaufenen Anfragen erneut ein, erkennbar an ihrer custom_id. Die Qualität des Prompts bestimmt die Wiederholungskosten. Bei 1.000 Dokumenten bedeuten 90 Prozent Erfolg im ersten Durchlauf 100 Wiederholungen, 60 Prozent dagegen 400.

Schreiben Sie Vorschläge nie ungeprüft in produktive Felder. Laut API-Referenz für Message Batches sind Ergebnisse selbst bei Temperatur 0,0 nicht vollständig deterministisch. Bei Svennis legen wir für Ergebnisse aus einem Stapel ein eigenes Prüffeld in Zoho an und lassen das Fachteam eine Stichprobe daraus kontrollieren. Erst nach dessen Freigabe übernehmen wir den Wert in das eigentliche Feld, sodass jede Änderung nachvollziehbar bleibt.

Batch API in deutschen Unternehmen: Workspace, Verarbeitungsregion und personenbezogene Daten

Für ein Unternehmen in Deutschland zählt bei der Massenverarbeitung vor allem der Datenweg. Ein Stapel enthält oft Tausende Datensätze mit Kundendaten auf einmal. Vier Punkte der Batch API sind dafür relevant:

  • Workspace. Stapel sind auf den Workspace beschränkt, in dem sie angelegt wurden, und nur mit API-Anfragen aus diesem Workspace erreichbar. Ein eigener Workspace für Zoho-Stapel trennt diese Daten von anderen Projekten.
  • Verarbeitungsregion. Der Parameter inference_geo legt die geografische Region der Verarbeitung fest. Ohne Angabe gilt die Voreinstellung default_inference_geo des Workspace, die Sie vor dem ersten echten Stapel prüfen sollten.
  • Aufbewahrung. Ergebnisse bleiben 29 Tage abrufbar. Holen Sie sie zeitnah ab und speichern Sie sie dort, wo Ihre übrigen Kundendaten liegen.
  • Kennungen. Das Feld user_id in den Metadaten nutzt Anthropic zur Missbrauchserkennung, Namen, E-Mail-Adressen und Telefonnummern gehören dort nicht hinein. Für die custom_id gilt dasselbe Prinzip: Ticket-ID statt Kundenname.

Senden Sie im Stapel nur die Felder, die Claude für die Aufgabe tatsächlich braucht, etwa Betreff und Text statt des vollständigen Kontaktdatensatzes. Welche Verträge Sie benötigen und welche Daten nie ins Modell gehören, behandelt unser Beitrag Claude DSGVO-konform nutzen.

Nächste Schritte: einen Pilotstapel mit einem Zoho-Bestand aufsetzen

Ein erster Pilotstapel lässt sich mit überschaubarem Aufwand planen. Gehen Sie dabei in dieser Reihenfolge vor:

  1. Wählen Sie einen Bestand, auf den niemand sofort wartet und der mindestens rund 1.000 Datensätze umfasst, etwa offene Tickets oder ältere Leads.
  2. Legen Sie in Zoho ein Prüffeld an, in das die Vorschläge zuerst geschrieben werden.
  3. Testen Sie den Prompt an 5 bis 10 typischen Datensätzen, bevor der volle Bestand in den Stapel geht.
  4. Wählen Sie das Modell: Claude Haiku 5.5 für Klassifizierung und Extraktion, Claude Opus 5.5, wenn die Wahl unklar ist.
  5. Planen Sie den Zeitplan so, dass auch der schlechteste Fall von 24 Stunden hineinpasst.
  6. Prüfen Sie eine Stichprobe der Ergebnisse und übernehmen Sie die Werte erst danach.

Für den technischen Anschluss brauchen Sie einen Ablauf, der Daten exportiert, den Stapel einreicht und die Ergebnisse zurückschreibt. Wie Sie Claude dafür aus Ihren Zoho-Abläufen aufrufen, zeigt der Beitrag Claude in Zoho Flow und Deluge einbinden.

Quellen

  1. Anthropic: Batch processing (Claude Platform Docs)
  2. Anthropic: Create a Message Batch (API-Referenz)
  3. Claude API: Batch (API-Referenz)
  4. Anthropic: Models overview
  5. Anthropic Newsroom
  6. Claude Certification Guide: Batch Processing Strategies
  7. Developers Digest: Claude Batch API Production Guide
  8. OpenRelay: Claude Batch API, How Message Batches Work
Kostenlos, 30 Minuten

Wählen Sie einen Termin. Bringen Sie den Prozess mit, an den Sie beim Lesen gedacht haben.

Sie erhalten ein klares Ja oder Nein zur Automatisierung mit Claude und den passenden Schritt laut veröffentlichter Preisliste. Sie sprechen mit den Menschen, die die KI-Agenten bauen, nicht mit dem Vertrieb.

Lieber anrufen? +40 722 567 135 · Lieber erst selbst ausprobieren? Zuerst die kostenlose Analyse.

30 Minuten · Video · kostenlos
  1. 1Termin
  2. 2Ihre Angaben
  3. 3Gebucht