Zum Inhalt springen
SVENNISAIWe speak Claude.
Blog · Claude API

API-Kosten von Claude mit Prompt Caching senken: Aufbau, Laufzeit, Fehlerquellen

Prompt Caching macht den gleichbleibenden Teil jeder Claude-Anfrage bis zu zwanzigmal günstiger. Dieser Leitfaden zeigt Aufbau, Cache-Laufzeit, typische Fehler und die Kontrolle auf der Rechnung.

10 Min. Lesezeit
Beitrag · 10 Min. Lesezeit
Abstrakte Darstellung wiederkehrender Blöcke, die gestapelt und mehrfach wiederverwendet werden

Prompt Caching senkt die API-Kosten von Claude für den wiederholten Prompt-Anfang

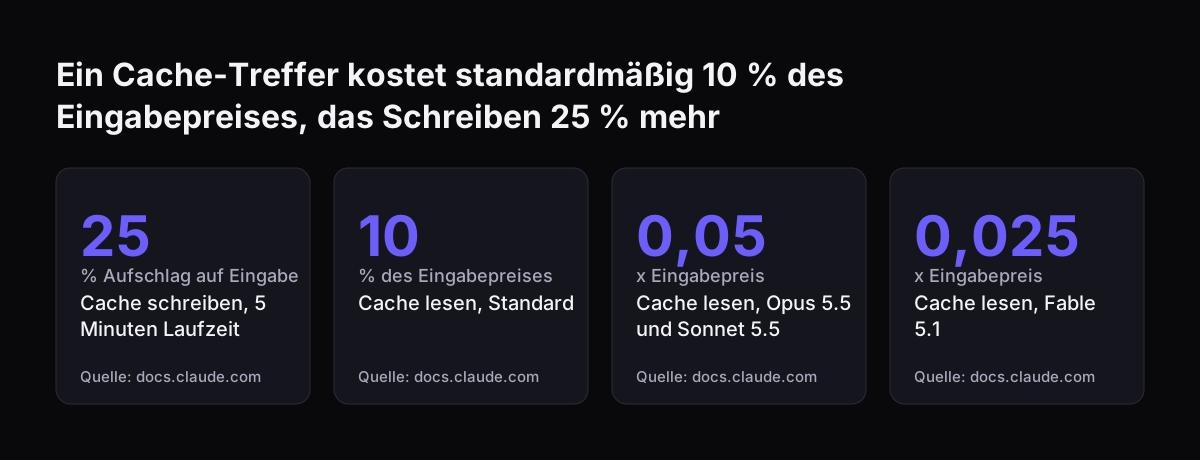
Die API-Kosten von Claude senken Sie mit Prompt Caching, indem der gleichbleibende Anfang jeder Anfrage einmal in den Cache geschrieben und danach günstig wiederverwendet wird. Ein Cache-Treffer kostet laut Anthropic standardmäßig 10 Prozent des normalen Eingabepreises. Bei Claude Opus 5.5 und Claude Sonnet 5.5 sind es nur 5 Prozent.

Prompt Caching ist die Wiederverwendung bereits verarbeiteter Prompt-Teile über mehrere API-Aufrufe hinweg. Claude liest diese Teile dann aus dem Cache, statt sie neu zu verarbeiten. Laut der Dokumentation zum Prompt Caching verkürzt das zusätzlich die Verarbeitungszeit bei wiederkehrenden Aufgaben.

Für produktive Assistenten ist der Effekt groß. Ein Service- oder Vertriebsassistent schickt bei jeder Anfrage dieselbe Systemanweisung, dieselben Tool-Definitionen und oft denselben Wissensbestand mit. Dieser feste Block ist häufig um ein Vielfaches länger als die eigentliche Frage. Ohne Caching zahlen Sie ihn bei jedem Aufruf zum vollen Eingabepreis.

Anthropic unterstützt Prompt Caching auf allen aktiven Claude-Modellen, automatisch wie explizit. Die Ersparnis betrifft nur Eingabe-Tokens. Tokens sind die Textstücke, die ein Modell verarbeitet und nach denen die API abrechnet. Die Ausgabe-Tokens, also die Antwort, kosten mit und ohne Cache dasselbe.
Was der Claude-Cache speichert und was er nicht verändert

Der Claude-Cache speichert einen Prompt-Anfang, das sogenannte Präfix, bis zu einer festgelegten Stelle. Diese Stelle heißt Cache-Breakpoint. Ein Treffer entsteht nur, wenn der Anfang der neuen Anfrage exakt zu dem passt, was gespeichert wurde. Weicht ein einziges Zeichen im Präfix ab, verarbeitet Claude den Anfang neu.

Prompt Caching verändert die Antwort nicht. Laut Anthropic ist die Ausgabe identisch mit der, die Sie ohne Caching erhalten würden. Sie müssen Ihre Qualitätsprüfung also nicht wegen des Caches neu aufsetzen. Sie prüfen nur, ob der Cache tatsächlich greift.

Drei weitere Eigenschaften des Caches sind für den Betrieb wichtig:

  • Trennung nach Organisation: Caches sind zwischen Organisationen isoliert und werden nie geteilt, auch nicht bei identischen Prompts.
  • Rate Limits: Cache-Treffer werden nicht auf Ihr Rate Limit angerechnet. Bei hoher Last bleibt dadurch mehr Spielraum für neue Anfragen.
  • Zwei Abrechnungsposten: Das Schreiben in den Cache kostet mehr als normale Eingabe, das Lesen deutlich weniger.

Die Rechnung lohnt sich deshalb nur, wenn derselbe Prompt-Anfang mehrfach gelesen wird. Ein Präfix, das nur einmal genutzt wird, kostet mit Cache mehr als ohne. Für einen Assistenten mit vielen Anfragen pro Stunde ist dagegen fast jeder Aufruf ein Lesezugriff.

Preise für Cache-Schreiben und Cache-Lesen je Claude-Modell

Die Cache-Preise leiten sich vom Eingabepreis des jeweiligen Modells ab. Laut der Preisseite von Anthropic kostet das Schreiben mit fünf Minuten Laufzeit 25 Prozent mehr als normale Eingabe. Die Laufzeit von einer Stunde kostet das Doppelte des Eingabepreises. Das Lesen kostet standardmäßig 10 Prozent, mit Ausnahmen für einzelne Modelle.

Die folgende Tabelle rechnet diese Faktoren für die aktuellen Modelle aus. Alle Werte sind US-Dollar pro einer Million Tokens. Bei Claude Haiku 5.5 gilt der Eingabepreis für Prompts bis 100.000 Tokens.

ModellEingabeCache schreiben, 5 Min.Cache schreiben, 1 Std.Cache lesen
Claude Fable 5.110,0012,5020,000,25 (Faktor 0,025)
Claude Opus 5.54,005,008,000,20 (Faktor 0,05)
Claude Sonnet 5.52,002,504,000,10 (Faktor 0,05)
Claude Haiku 5.50,100,1250,200,01 (Standardfaktor 0,1)

Die Tabelle zeigt zwei Dinge. Erstens amortisiert sich ein Schreibvorgang mit fünf Minuten Laufzeit bereits beim ersten Lesezugriff. Zweitens ist der Hebel bei den großen Modellen am stärksten, weil dort der Eingabepreis hoch und der Lesefaktor niedrig ist. Die Ausgabepreise bleiben unverändert, etwa 10 US-Dollar pro Million Tokens bei Claude Sonnet 5.5.

Ein Cache-Treffer kostet standardmäßig 10 % des Eingabepreises, das Schreiben 25 % mehr: Cache schreiben, 5 Minuten Laufzeit 25 % Aufschlag auf Eingabe, Cache lesen, Standard 10 % des Eingabepreises, Cache lesen, Opus 5.5 und Sonnet 5.5 0,05 x Eingab
Quelle: docs.claude.com

Cache-Lebensdauer: fünf Minuten als Standard, eine Stunde gegen Aufpreis

Ein Eintrag im Claude-Cache lebt standardmäßig fünf Minuten. Jede Nutzung erneuert diese Frist ohne Zusatzkosten. Ein Assistent mit gleichmäßigem Verkehr hält seinen Cache dadurch über den ganzen Arbeitstag warm. Erst eine Pause von mehr als fünf Minuten führt dazu, dass der nächste Aufruf neu schreiben muss.

Die Laufzeit von einer Stunde kostet beim Schreiben das Doppelte des Eingabepreises. Sie lohnt sich, wenn zwischen den Anfragen regelmäßig mehr als fünf, aber weniger als sechzig Minuten liegen. Typisch ist ein interner Assistent, den einige Mitarbeitende nur gelegentlich fragen. Mit fünf Minuten Laufzeit würde dort fast jede Anfrage neu schreiben und damit 25 Prozent mehr zahlen als ganz ohne Cache.

Cache vorwärmen mit max_tokens: 0

Cache-Vorwärmen bedeutet, die Systemanweisung oder die Tool-Definitionen in den Cache zu laden, bevor ein Nutzer die erste echte Anfrage stellt. Dazu senden Sie eine Anfrage mit max_tokens auf 0. Claude erzeugt dann keine Antwort, schreibt aber den Cache. Die erste echte Anfrage des Tages ist damit bereits ein Lesezugriff.

Innerhalb der Message Batches lehnt die API eine solche Anfrage mit max_tokens: 0 ab. Das Vorwärmen gehört deshalb in den normalen, synchronen Aufrufweg Ihres Assistenten.

Prompt-Aufbau für den Cache: stabile Teile nach vorne, veränderliche nach hinten

Ein cachefreundlicher Prompt beginnt mit allem, was sich zwischen Anfragen nicht ändert, und endet mit allem, was sich ändert. Der Cache greift nur auf den identischen Anfang. Jede veränderliche Angabe weiter vorn beendet das wiederverwendbare Präfix an dieser Stelle.

Anthropic bietet zwei Wege, das Caching einzuschalten. Automatisches Caching ist ein einzelnes Feld cache_control auf oberster Ebene der Anfrage. Das System setzt den Breakpoint dann auf den letzten cachebaren Block und schiebt ihn mit wachsendem Gespräch nach vorn. Explizite Breakpoints setzen Sie dagegen direkt auf einzelne Inhaltsblöcke, bis zu vier pro Anfrage.

Die folgende Übersicht ordnet die üblichen Teile eines Assistenten-Prompts ein:

Prompt-TeilPositionCachen?Hinweis
Tool-Definitionenganz vornjaändern sich nur bei neuen Versionen
Systemanweisungvornjaohne Datum, Namen oder Kundennummer
Wissensbestand, etwa Richtlinien oder Produktlistenach der Systemanweisungja, eigener BreakpointAktualisierung bewusst bündeln
Bisheriger GesprächsverlaufMitteja, wandernder Breakpointautomatisches Caching passt hierher
Veränderliche Angaben, etwa Datum oder Ticketnummerhintenneinnach dem letzten Breakpoint einfügen
Aktuelle Nutzerfrageganz hintenneinwird ohnehin jedes Mal neu bezahlt

Bei langen Gesprächen gilt eine technische Grenze. Das System prüft beim Rückwärtssuchen höchstens 20 Positionen pro Breakpoint. Liegen mehr Blöcke zwischen dem letzten Treffer und dem neuen Breakpoint, setzen Sie einen zusätzlichen Breakpoint weiter vorn.

Rechenbeispiel: ein Service-Assistent vor Zoho Desk auf Claude Sonnet 5.5

Ein Service-Assistent auf Claude Sonnet 5.5 spart mit Prompt Caching im folgenden Beispiel rund 93 Prozent der Kosten für den festen Prompt-Anfang. Der Assistent beantwortet Kundenanfragen, bevor sie als Ticket in Zoho Desk landen. Die Zahlen zum Umfang sind Annahmen, die Preise stammen von der Preisseite von Anthropic.

Das feste Präfix umfasst 20.000 Tokens:

  • Tool-Definitionen für Ticketsuche und Ticketanlage: 5.000 Tokens
  • Systemanweisung mit Tonfall, Eskalationsregeln und Zuständigkeiten: 3.000 Tokens
  • Wissensbestand mit Produktbeschreibungen und Garantiebedingungen: 12.000 Tokens

Der Assistent bearbeitet 1.000 Anfragen pro Arbeitstag. Wegen Pausen über fünf Minuten wird der Cache annahmegemäß 20-mal am Tag neu geschrieben.

PostenTokens pro TagPreis je MillionKosten pro Tag
Ohne Cache: Präfix bei jeder Anfrage20.000.0002,00 USD40,00 USD
Mit Cache: 20 Schreibvorgänge400.0002,50 USD1,00 USD
Mit Cache: 980 Lesezugriffe19.600.0000,10 USD1,96 USD

Mit Cache kostet das Präfix also 2,96 statt 40,00 US-Dollar pro Tag. Unverändert bleiben die Kosten für die eigentliche Kundenfrage und für die Antwort. Rechnen Sie das Beispiel mit Ihren eigenen Präfixlängen und Anfragezahlen nach, bevor Sie Budgets festlegen.

Wo Prompt Caching in der Praxis unbemerkt bricht

Prompt Caching scheitert meist still: Die Anfrage läuft, die Antwort stimmt, nur die Ersparnis fehlt. Die API gibt in diesen Fällen keinen Fehler zurück. Fünf Ursachen sind besonders häufig.

Präfix unter der Mindestlänge

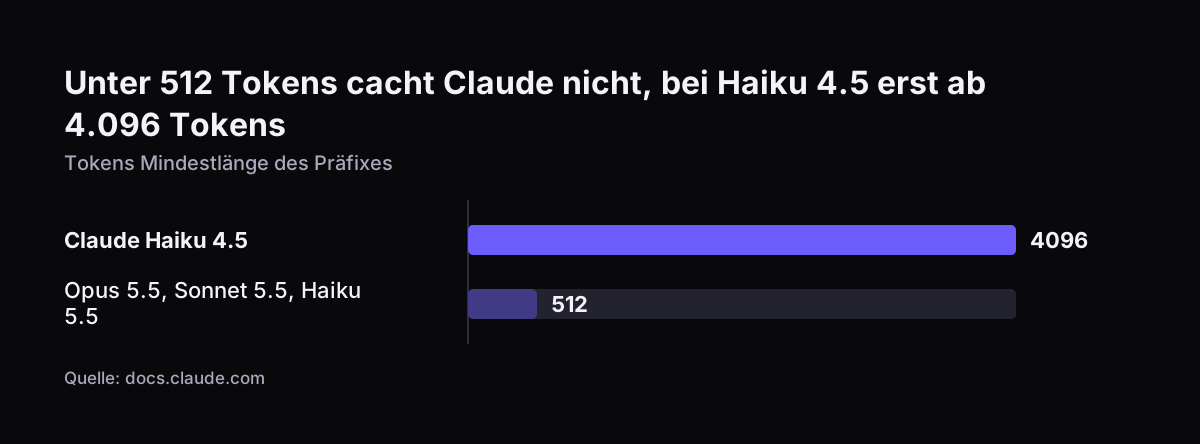
Anfragen unter der Mindestlänge werden laut Anthropic ohne Caching verarbeitet, ohne Fehlermeldung. Für Claude Fable 5.1, Opus 5.5, Opus 5, Sonnet 5.5 und Haiku 5.5 liegt die Grenze bei 512 Tokens. Für Claude Haiku 4.5 liegt sie bei 4.096 Tokens. Ein Entwickler beschreibt auf Reddit genau diesen Fall: Sein Systemprompt hatte etwa 1.500 Tokens, und jeder Aufruf meldete null geschriebene und null gelesene Cache-Tokens. Seine Lösung war, gemeinsamen Inhalt aus der Nutzernachricht in den Systemblock zu verschieben.

Veränderliche Angaben im Präfix

Ein Datum, ein Nutzername oder eine Ticketnummer am Anfang der Systemanweisung macht jedes Präfix einzigartig. Der Cache wird dann bei jeder Anfrage geschrieben und nie gelesen.

Lange Pausen, parallele Erstaufrufe, lange Gespräche

  • Pausen über fünf Minuten lassen den Standard-Cache verfallen.
  • Parallele Aufrufe vor dem ersten Schreibvorgang finden noch keinen Cache. Der Reddit-Autor lässt deshalb einen ersten Aufruf allein laufen und startet die übrigen erst danach parallel.
  • Mehr als 20 Blöcke seit dem letzten Breakpoint überschreiten das Suchfenster.

Prüfen Sie jede Prompt-Änderung vor dem Livegang auf diese Punkte. Wie Sie das systematisch tun, beschreibt der Leitfaden zum Testen und Versionieren von Claude-Prompts.

Unter 512 Tokens cacht Claude nicht, bei Haiku 4.5 erst ab 4.096 Tokens: Claude Haiku 4.5 4096, Opus 5.5, Sonnet 5.5, Haiku 5.5 512 (Tokens Mindestlänge des Präfixes)
Quelle: docs.claude.com

Die Ersparnis von Prompt Caching in den Nutzungsdaten und auf der Rechnung ablesen

Die Ersparnis lesen Sie zuerst in der Antwort jedes API-Aufrufs ab, nicht erst auf der Monatsrechnung. Jede Antwort enthält Nutzungsfelder. Das Feld cache_creation_input_tokens zeigt die Tokens, die in den Cache geschrieben wurden. Das Feld cache_read_input_tokens zeigt die Tokens, die aus dem Cache gelesen wurden.

Das Muster eines funktionierenden Caches ist eindeutig. Der erste Aufruf nach einer Pause schreibt, die folgenden lesen. Stehen bei einem Präfix über der Mindestlänge in beiden Feldern dauerhaft Nullen, greift der Cache nicht. Der Reddit-Autor weist darauf hin, dass dieses Bild nicht von einem gar nicht eingerichteten Caching zu unterscheiden ist.

Bei Svennis lesen wir vor jeder Freigabe einer geänderten Systemanweisung oder neuer Tool-Definitionen die Cache-Felder der ersten Antworten aus. Erst wenn dort Lesezugriffe auftauchen, geht die Änderung in den Betrieb.

Was auf der Rechnung steht

Die Claude-API hat keine Monatsgebühr und rechnet pro Token ab. Zwischengespeicherte Tokens erscheinen weiterhin in der Nutzungsabrechnung, nur zum niedrigeren Lesesatz. Für die Kontrolle multiplizieren Sie geschriebene Tokens mit dem Schreibpreis und gelesene Tokens mit dem Lesepreis aus der Tabelle oben. Wer über Claude Platform on AWS abrechnet, sieht stattdessen Claude Consumption Units. Diese entstehen aus der Token-Nutzung zu Standardpreisen und werden zu 0,01 US-Dollar je Einheit umgerechnet.

Prompt Caching zusammen mit Modellwahl und Batch API einsetzen

Prompt Caching ersetzt weder die passende Modellwahl noch die Batch API, sondern ergänzt beide. Die drei Hebel wirken auf unterschiedliche Teile der Rechnung. Caching senkt die Kosten des wiederholten Eingabe-Präfixes. Die Modellwahl bestimmt den Grundpreis für Eingabe und Ausgabe. Die Batch API halbiert beides für Aufgaben, die nicht sofort fertig sein müssen.

Bei der Modellwahl empfiehlt Anthropic, im Zweifel mit Claude Opus 5.5 zu beginnen. Für Aufgaben mit hohem Volumen und geringer Wartezeit, etwa Klassifizierung, Extraktion und Weiterleitung, positioniert Anthropic Claude Haiku 5.5. Ein Assistent kann beides kombinieren: Haiku ordnet die Anfrage zu, ein größeres Modell formuliert die Antwort. Jedes Modell braucht dabei sein eigenes, cachefreundlich aufgebautes Präfix.

Die Batch API verarbeitet große Mengen von Anfragen asynchron mit 50 Prozent Rabatt auf Eingabe- und Ausgabe-Tokens. Das Vorwärmen mit max_tokens: 0 funktioniert dort nicht, wie oben beschrieben. Wann sich die Batch API für Massenverarbeitung lohnt, erklärt der Beitrag zur Massenverarbeitung mit der Claude Batch API.

Prompt Caching für Unternehmen in Deutschland: Währung, Datenweg, Abo-Abgrenzung

Für Unternehmen in Deutschland ist die API-Abrechnung von Claude zuerst eine Dollar-Rechnung. Anthropic nennt die Preise in US-Dollar ohne Steuern. Planen Sie deshalb einen Puffer für Wechselkursschwankungen ein, wenn Sie Budgets in Euro festlegen.

Beim Datenweg gibt es eine Einstellung, die die Kosten direkt erhöht. Wer über den Parameter inference_geo eine Verarbeitung ausschließlich in den USA festlegt, zahlt ab Claude Opus 4.6 einen Aufschlag von Faktor 1,1 auf alle Token-Kategorien. Der Aufschlag trifft auch Cache-Schreiben und Cache-Lesen. Ältere Modelle unterstützen den Parameter nicht und antworten mit einem Fehler 400.

Für die Datenschutzbewertung hilft die Trennung der Caches. Caches sind nach Organisation isoliert, und verschiedene Organisationen teilen nie einen Cache. Ein Wissensbestand, den Sie cachen, wird also nicht für fremde Anfragen anderer Organisationen wiederverwendet.

Die API ist außerdem klar von den Abos zu trennen. Pro, Team und Max werden pro Person oder Platz bezahlt und folgen Nutzungslimits, nicht dem Token-Preis. Die Unterschiede dieser Pläne zeigt die Übersicht zu Claude-Preisen für Pro, Team und Max. Prompt Caching im Sinne dieses Leitfadens betrifft nur Anwendungen, die Claude über die API aufrufen.

Nächste Schritte: Prompt Caching für Ihren Claude-Assistenten prüfen und einrichten

Den Nutzen von Prompt Caching prüfen Sie am schnellsten mit den Daten Ihres laufenden Assistenten. Dafür brauchen Sie keine neue Architektur, sondern eine Bestandsaufnahme des Prompts und der Nutzungsfelder. Gehen Sie in dieser Reihenfolge vor:

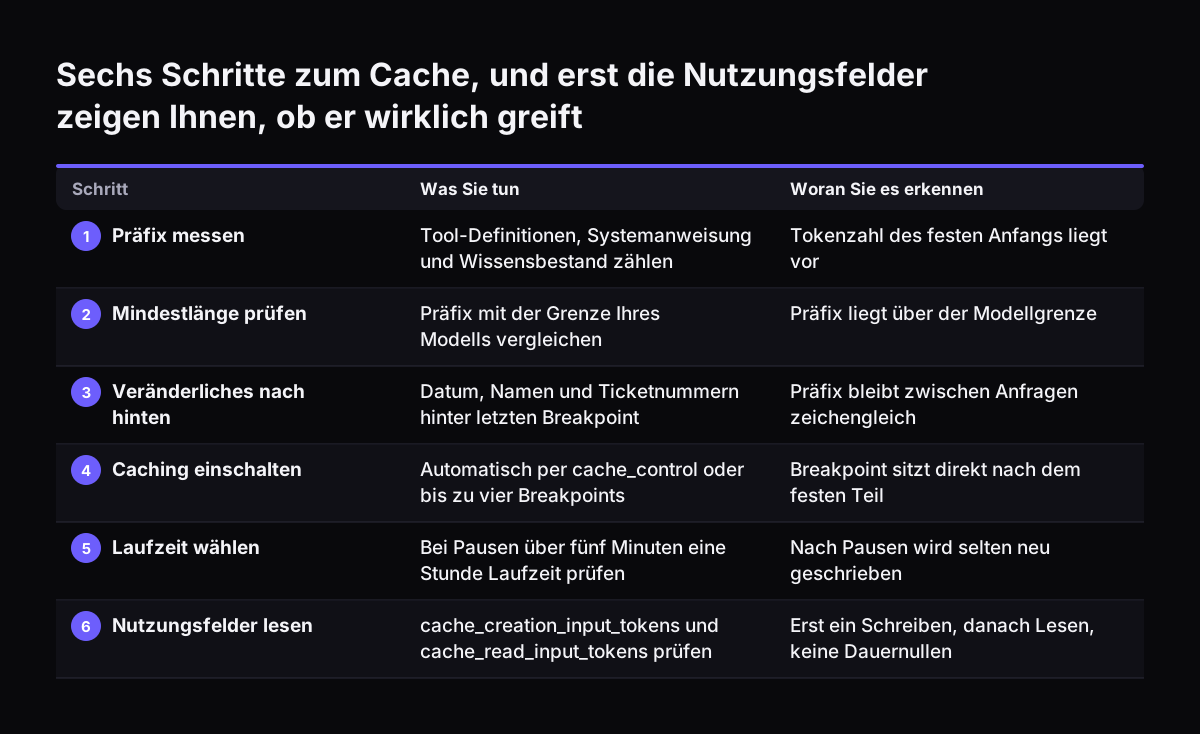
  1. Messen Sie die Länge des festen Präfixes aus Tool-Definitionen, Systemanweisung und Wissensbestand.
  2. Prüfen Sie, ob das Präfix über der Mindestlänge Ihres Modells liegt.
  3. Verschieben Sie Datum, Namen und Ticketnummern hinter den letzten Breakpoint.
  4. Wählen Sie zwischen automatischem Caching und bis zu vier expliziten Breakpoints.
  5. Entscheiden Sie anhand der Pausen zwischen Anfragen über fünf Minuten oder eine Stunde Laufzeit.
  6. Lesen Sie cache_creation_input_tokens und cache_read_input_tokens in den ersten Antworten aus.
  7. Rechnen Sie die Ersparnis mit den Preisen der Preisseite von Anthropic nach.

Wenn Sie den Assistenten erst aufbauen, gehört die Cache-Struktur von Anfang an in die Planung. Im Claude-Workshop legen Sie fest, welcher Prozess sich lohnt. Im Pilot A mit einem KI-Agenten auf Claude entsteht daraus ein laufender Assistent für einen Prozess, inklusive Prompt-Aufbau und Kostenkontrolle. Die Konditionen der einzelnen Schritte finden Sie auf der Preisseite von Svennis AI.

Sechs Schritte zum Cache, und erst die Nutzungsfelder zeigen Ihnen, ob er wirklich greift. Was Sie tun / Woran Sie es erkennen. 1. Präfix messen: Tool-Definitionen, Systemanweisung und Wissensbestand zählen / Tokenzahl des festen Anfangs liegt vor; 2

Quellen

  1. Anthropic: Pricing, Claude Platform Docs
  2. Anthropic: Prompt caching, Claude Platform Docs
  3. Anthropic: Models overview, Claude Platform Docs
  4. Reddit r/ClaudeAI: Anthropic prompt caching fails silently
  5. OmniaKey: Claude Preise 2026, Pläne, Nutzungslimits und Modelle
  6. OmniaKey: Claude Code, Tokenverbrauch reduzieren
Kostenlos, 30 Minuten

Wählen Sie einen Termin. Bringen Sie den Prozess mit, an den Sie beim Lesen gedacht haben.

Sie erhalten ein klares Ja oder Nein zur Automatisierung mit Claude und den passenden Schritt laut veröffentlichter Preisliste. Sie sprechen mit den Menschen, die die KI-Agenten bauen, nicht mit dem Vertrieb.

Lieber anrufen? +40 722 567 135 · Lieber erst selbst ausprobieren? Zuerst die kostenlose Analyse.

30 Minuten · Video · kostenlos
  1. 1Termin
  2. 2Ihre Angaben
  3. 3Gebucht