Skip to content
SVENNISAIWe speak Claude.
Blog · API Claude

Costi dell'API Claude: prompt caching ed elaborazione batch con una stima mensile

Guida ai costi dell'API Claude: come si pagano i token, quando prompt caching ed elaborazione batch abbassano la fattura e come stimare la spesa mensile di un agente.

10 min di lettura
Articolo · 10 min di lettura
Forme astratte che si ripetono identiche e si raggruppano in lotti, a evocare riuso del contesto e richieste differite

Costi dell'API Claude: si pagano i token, caching e batch ne riducono il prezzo

I costi dell'API Claude dipendono dai token: si paga ogni milione di token in ingresso e in uscita, con un prezzo diverso per ogni modello. Il prompt caching riduce il costo dell'input che si ripete identico tra una chiamata e l'altra. L'elaborazione batch dimezza input e output per le richieste che possono attendere la risposta.

L'API Claude è l'interfaccia di programmazione con cui un'applicazione invia richieste ai modelli di Anthropic. La fattura segue il consumo effettivo, non il numero di utenti. Per questo motivo un assistente o un agente in produzione costa in base a come è progettato, oltre che in base a quanto lavora.

Questa guida spiega le voci di costo una alla volta. Poi mostra quando prompt caching ed elaborazione batch fanno risparmiare davvero e quando no. Al centro c'è una stima mensile completa per un agente che classifica ticket, con i prezzi presi dalla pagina dei prezzi della Claude Platform di Anthropic.

Un avvertimento vale per tutto il testo: Anthropic indica i prezzi in dollari statunitensi. Le cifre che seguono sono quindi in USD, come le pubblica il produttore.
Come Anthropic fattura i token di input e di output

Anthropic fattura separatamente i token di input e i token di output, ciascuno a un prezzo per milione di token. I token sono i frammenti di testo che il modello elabora. L'input comprende istruzioni, prompt di sistema, documenti e cronologia della conversazione. L'output è il testo che il modello genera.

I listini attuali per i modelli più recenti sono questi, in USD per milione di token. La colonna batch applica lo sconto del 50 per cento che Anthropic riconosce su tutto l'utilizzo della Batch API.

ModelloInputOutputInput / output in batchUso indicato da Anthropic
Claude Haiku 5.5da 0,10da 0,50metà del listinoalti volumi: classificazione, estrazione, smistamento
Claude Sonnet 5.52101 / 5equilibrio tra velocità e intelligenza
Claude Opus 5.54202 / 10lavoro agentico lungo; punto di partenza consigliato
Claude Fable 5.28404 / 20ragionamento impegnativo, lavoro agentico di lunga durata

L'output costa cinque volte l'input su tutti questi modelli. Una risposta lunga pesa quindi molto più di un prompt lungo. Inoltre i modelli più recenti, dalla generazione 4.7 in poi, usano un tokenizer che produce circa il 30 per cento di token in più per lo stesso testo. Una stima fatta contando le parole va quindi corretta verso l'alto.

Prompt caching: cosa è e quanto costano scrittura e lettura della cache

Il prompt caching è il meccanismo che riduce costi e latenza riutilizzando parti del prompt già elaborate nelle chiamate API precedenti. Funziona su tutti i modelli Claude attivi, sia in modalità automatica sia con punti di cache espliciti.

Il prompt caching introduce due voci di costo nuove, entrambe calcolate sul prezzo base dell'input:

  • Scrittura in cache di 5 minuti: 1,25 volte il prezzo base, cioè il 25 per cento in più.
  • Scrittura in cache di un'ora: 2 volte il prezzo base.
  • Lettura dalla cache: di norma il 10 per cento del prezzo base; su Claude Opus 5.5 e Claude Sonnet 5.5 scende a 0,05 volte.

Su Claude Sonnet 5.5 una lettura costa quindi 0,10 USD per milione di token, contro i 2 USD dell'input normale. Su Claude Fable 5.2 la lettura scende a 0,025 volte il prezzo base.

La cache predefinita dura 5 minuti. Ogni volta che il contenuto in cache viene usato, la durata si rinnova senza costi aggiuntivi. La modalità automatica richiede un solo campo cache_control nella richiesta e sposta il punto di cache in avanti man mano che la conversazione cresce. I punti espliciti, fino a 4 per richiesta, decidono invece blocco per blocco cosa mettere in cache.

Esiste una lunghezza minima: 512 token per Claude Opus 5.5, Claude Sonnet 5.5 e Claude Haiku 5.5, ma 4.096 token per Claude Haiku 4.5. Chi usa ancora quel modello trova il confronto nella guida su Claude Haiku 4.5 in azienda.

Quando il prompt caching non fa risparmiare

Il prompt caching non fa risparmiare quando il prefisso del prompt cambia da una chiamata all'altra. Anthropic richiede segmenti identici al 100 per cento, testo e immagini compresi, fino al blocco marcato con cache_control. Basta un carattere diverso all'inizio e la cache non viene letta.

Le cause più comuni di una cache che non rende sono queste:

  • Un dato variabile, come data, ora o nome utente, inserito all'inizio del prompt di sistema.
  • Definizioni degli strumenti modificate: cambiare nomi, descrizioni o parametri invalida l'intera cache.
  • Un prefisso sotto la lunghezza minima: la richiesta viene elaborata senza cache e non compare alcun errore.
  • Pause tra le richieste più lunghe della durata della cache, misurata dall'inizio della richiesta e non dalla fine della risposta.

Il prompt caching inoltre non tocca l'output. La risposta è identica a quella senza cache e i token generati costano come prima. Le cache sono isolate tra organizzazioni: due aziende con lo stesso prompt non condividono mai la cache.

In Svennis, quando mettiamo in produzione un agente su Claude, controlliamo il campo cache_read_input_tokens già nelle prime chiamate di prova: se non registra letture, quasi sempre un dato variabile è finito nel prompt di sistema e rompe il prefisso. Spostarlo in fondo al messaggio è di solito la correzione che sblocca il risparmio.

Elaborazione batch: metà prezzo in cambio di risposte non immediate

L'elaborazione batch dimezza il costo di input e output per le richieste che non richiedono una risposta immediata. La Message Batches API è l'interfaccia che elabora in modo asincrono grandi volumi di richieste: ogni richiesta viene gestita in modo indipendente e i risultati si scaricano a elaborazione conclusa.

Secondo la documentazione Anthropic sull'elaborazione batch, la maggior parte dei batch termina in meno di un'ora. Un batch scade però se non si completa entro 24 ore. Le regole operative principali sono queste:

  • Un batch contiene al massimo 100.000 richieste o 256 MB, il limite raggiunto per primo.
  • Ogni richiesta ha un custom_id univoco, da 1 a 64 caratteri alfanumerici, trattini o trattini bassi.
  • I risultati restano scaricabili per 29 giorni dalla creazione.
  • Le richieste in errore, annullate o scadute non vengono fatturate.
  • I parametri stream, speed, fallbacks e max_tokens: 0 non sono supportati.

Tutti i modelli attivi supportano la Batch API. L'uso dei batch non incide sui limiti di frequenza della Messages API: un'elaborazione notturna non rallenta l'assistente che risponde agli utenti durante il giorno. I batch restano isolati nel Workspace in cui sono stati creati.

Il batch serve quindi a lavori differibili: riclassificare l'archivio dei ticket, arricchire anagrafiche, produrre riepiloghi notturni. Non serve a una chat che deve rispondere mentre il cliente attende.

Tabella di decisione: quale riduzione dei costi usare per ogni caso d'uso

La scelta tra prompt caching, elaborazione batch ed entrambi dipende da due domande. La prima è se lo stesso contesto si ripete identico. La seconda è se la risposta può attendere. La tabella riassume le combinazioni più frequenti in un'azienda.

SituazioneStrumentoEffetto sul costoVincolo principale
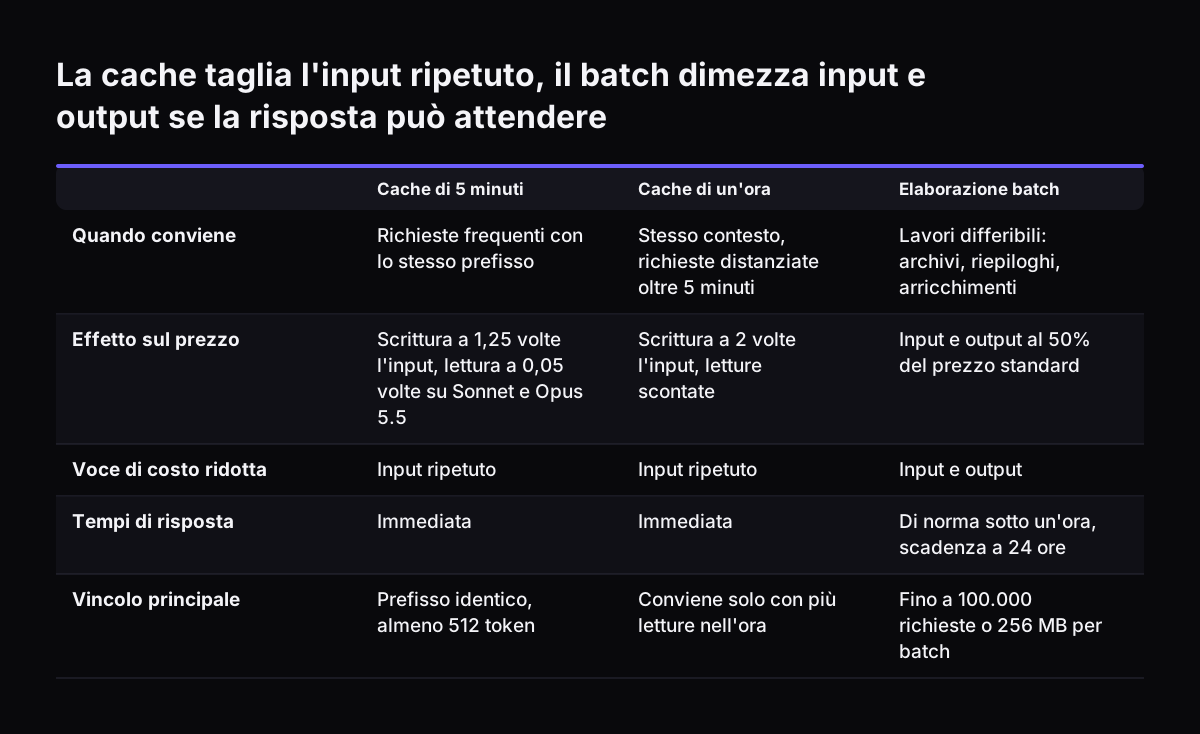
Assistente con lungo prompt di sistema e richieste frequentiCache di 5 minutiLetture a 0,05 volte l'input su Sonnet 5.5 e Opus 5.5Prefisso identico, almeno 512 token
Stesso contesto, richieste distanziate oltre 5 minutiCache di un'oraScrittura a 2 volte l'input, letture scontateConviene solo con più letture nell'ora
Lavori differibili: archivi, riepiloghi, arricchimentiBatchMetà prezzo su input e outputRisposta entro 24 ore, niente streaming
Grandi lotti con lo stesso contestoBatch e caching insiemeSconti cumulabiliLetture dalla cache garantite solo al meglio
Risposte in cui conta la velocità di generazioneFast modePrezzo maggiorato: Opus 5.5 a 8 / 40 USDNon disponibile con la Batch API

Per la combinazione di batch e caching Anthropic segnala percentuali di letture dalla cache che vanno dal 30 al 98 per cento, secondo il tipo di traffico. Nel preventivo conviene quindi calcolare entrambi gli estremi. Il fast mode compare in tabella per completezza: aumenta fino a 2,5 volte i token generati al secondo, ma alza la spesa invece di ridurla.

La cache taglia l'input ripetuto, il batch dimezza input e output se la risposta può attendere. Cache di 5 minuti / Cache di un'ora / Elaborazione batch. Quando conviene: Richieste frequenti con lo stesso prefisso / Stesso contesto, richieste distanz

Stima mensile di esempio: 10.000 ticket classificati con Claude Sonnet 5.5

Questa stima mensile mostra come prompt caching ed elaborazione batch cambiano la spesa di un agente che classifica ticket di assistenza in Zoho Desk. I volumi sono ipotesi di esempio; i prezzi sono quelli di Claude Sonnet 5.5 pubblicati da Anthropic.

Le ipotesi del calcolo sono queste:

  • 10.000 ticket al mese, una richiesta per ticket.
  • Prefisso fisso di 3.000 token: istruzioni, elenco delle categorie, esempi.
  • Testo variabile del ticket di 500 token, risposta di 300 token.
  • Con la cache: 500 scritture al mese, dovute alle pause oltre 5 minuti, e 9.500 letture.
ScenarioInput (USD)Output (USD)Totale mese (USD)
Standard, senza ottimizzazioni70,0030,00100,00
Prompt caching di 5 minuti16,6030,0046,60
Batch senza cache35,0015,0050,00
Batch con cache, letture dal 98 al 30 per centoda 7,22 a 31,7015,00da 22,22 a 46,70

Nello scenario con cache, l'input si scompone così: 3,75 USD di scritture (1,5 milioni di token a 2,50 USD), 2,85 USD di letture (28,5 milioni a 0,10 USD) e 10 USD di testo variabile. Lo scenario standard somma invece 35 milioni di token di input a 2 USD e 3 milioni di output a 10 USD.

Il dato da notare è un altro. Dopo il caching, l'output vale 30 USD su 46,60: il costo dominante è la risposta, che la cache non riduce.

La scelta del modello pesa più degli sconti sull'output

La scelta del modello incide sulla spesa più di caching e batch, perché cambia anche il prezzo dell'output. Nella stima mensile dell'esempio la risposta resta la voce maggiore. Solo un modello più economico o un output più breve la riducono in tempo reale.

Lo stesso carico di 10.000 ticket, a prezzi standard e senza cache, costerebbe su Claude Haiku 5.5 a partire da 5 USD al mese: 35 milioni di token di input a 0,10 USD e 3 milioni di output a 0,50 USD. Anthropic indica proprio Claude Haiku 5.5 per compiti ad alto volume come classificazione, estrazione e smistamento. Su Claude Opus 5.5 la stessa stima standard salirebbe a 200 USD.

Il modello più economico va però provato sui ticket reali prima di sceglierlo. Se sbaglia categoria più spesso, il risparmio si perde nelle correzioni manuali. Anthropic suggerisce di partire da Claude Opus 5.5 quando non è chiaro quale modello usare, e di scendere solo dopo test che lo giustificano.

Un secondo intervento riguarda la lunghezza della risposta. Per uno smistamento basta spesso una categoria e una motivazione breve, non un paragrafo. Ridurre l'output richiesto abbassa la voce più cara senza toccare il modello. Il confronto completo tra i modelli è nella pagina Claude prezzi 2026 in euro.

Impostare prompt caching e batch fin dalla progettazione dell'agente

Prompt caching ed elaborazione batch rendono di più quando l'agente è progettato attorno a loro fin dall'inizio. Aggiungerli dopo spesso richiede di riscrivere prompt e flussi. Le scelte da fissare nella progettazione sono queste, in ordine:

  1. Ordinare il prompt: prima istruzioni, definizioni degli strumenti e documenti fissi, poi i dati variabili della singola richiesta.
  2. Stabilizzare gli strumenti: le definizioni degli strumenti cambiano solo nei rilasci, perché ogni modifica invalida l'intera cache.
  3. Scegliere la durata della cache: 5 minuti per traffico continuo, un'ora quando le richieste sono distanziate ma ripetute.
  4. Preriscaldare la cache: una richiesta con max_tokens: 0 scrive la cache senza generare output, prima che arrivi il primo utente.
  5. Separare i flussi: le richieste che possono attendere vanno in batch, quelle interattive restano sulla Messages API.
  6. Misurare: il campo cache_read_input_tokens di ogni risposta dice quanti token sono stati letti dalla cache.

Il preriscaldamento riduce soprattutto la latenza della prima interazione, non solo il costo. Le letture dalla cache, inoltre, non vengono conteggiate nei limiti di frequenza. Un agente ben ordinato regge quindi più traffico con la stessa quota.

Ogni contenuto fisso del prompt va trattato con la stessa cura riservata al codice. Questo vale anche per i testi provenienti da fonti esterne, che possono contenere istruzioni nascoste: la guida su come proteggere gli agenti Claude dalla prompt injection spiega i controlli da prevedere.

Cosa significano questi costi per un'azienda italiana

Per un'azienda italiana i costi dell'API Claude hanno tre aspetti in più da considerare: la valuta, il canale di acquisto e la conservazione dei dati. Nessuno cambia la logica di caching e batch, ma tutti incidono sul preventivo e sulla valutazione interna.

Prezzi in dollari

Anthropic pubblica tutti i prezzi in USD. Il budget in euro va quindi aggiornato quando cambia il cambio, oppure calcolato con un margine prudente.

Canale di acquisto

Chi acquista Claude tramite Claude Platform on AWS paga in Claude Consumption Units attraverso AWS Marketplace. Lo stesso vale per Claude in Microsoft Foundry. L'utilizzo dei token viene valutato in USD e poi convertito in CCU, a 0,01 USD per unità. La fattura ha quindi un aspetto diverso da quella diretta di Anthropic.

Conservazione dei dati nei batch

L'elaborazione batch conserva richieste e risposte fino a 29 giorni dalla creazione del batch. Non rientra nella conservazione zero dei dati. Prima di mettere in batch testi con dati personali di clienti o dipendenti, il titolare del trattamento dovrebbe valutare questo periodo. Se l'azienda ha designato un responsabile della protezione dei dati, lo coinvolge nella valutazione. Un flusso interattivo con cache può essere un'alternativa per i contenuti più delicati. Anche la Messages API ha però regole proprie di conservazione dei dati, da verificare nei termini di Anthropic per il modello scelto prima di decidere.

Prossimi passi per stimare e ridurre la Sua spesa sull'API Claude

Il primo passo è misurare il carico reale prima di scegliere gli strumenti. Raccolga tre numeri per ogni processo che vuole affidare a Claude: richieste al mese, lunghezza della parte fissa del prompt e lunghezza tipica della risposta.

Con quei numeri può ripetere la stima mensile di questa guida in quattro passaggi:

  1. Calcolare il costo standard con il listino del modello scelto.
  2. Applicare il prompt caching alla parte fissa, se supera la lunghezza minima.
  3. Spostare in batch le richieste che possono attendere fino a 24 ore.
  4. Confrontare il risultato con un modello più leggero, provato sui casi reali.

Se il processo è uno solo e ben definito, il Pilot Claude A con un agente AI su Claude lo porta in produzione in 30 giorni, con i costi API misurati sul traffico vero. Il percorso completo prevede quattro passaggi: Workshop, Pilot Claude A o Pilot Claude B, Attivazione del reparto e gestione mensile. Per ogni collegamento ai Suoi programmi costruiamo un connector, un MCP server, un plugin o una skill, mostrando le opzioni con il loro costo; la scelta resta a Lei.

Le tariffe dei servizi sono sulla pagina dei prezzi di Workshop, Pilot, Attivazione e Gestione. Per un quadro più ampio su licenze e avvio, la pagina Claude per aziende: quanto costa e come iniziare è il punto di partenza.

Fonti

  1. Anthropic, Pricing - Claude Platform Docs
  2. Anthropic, Batch processing - Claude Platform Docs
  3. Anthropic, Prompt caching - Claude Platform Docs
  4. Anthropic, Models overview - Claude Platform Docs
Gratuita, 30 minuti

Scegliete un orario. Portate il processo a cui avete pensato leggendo.

Uscite con un sì o un no sull'affidarlo a Claude e con il passo giusto, secondo i prezzi pubblicati. Parlate con chi costruisce gli agenti, non con un commerciale.

Preferite telefonare? +39 02 9475 1997 · Non è ancora il momento di parlarne? Fate prima l'analisi gratuita della vostra azienda.

30 minuti · videochiamata · gratuita
  1. 1Orario
  2. 2I vostri dati
  3. 3Prenotato